选型之前,先把你的场景拆开看
做代理IP选型,最忌讳拿着参数表从头比到尾。参数漂亮不代表适合你——去年我先后帮两家客户做过测试,一家是电商公司,十几个店铺后台要日常维护;另一家做公开商品数据的采集,每天任务量在百万页面级。预算差不多,最后落地的方案却完全不同。这篇文章把两次实测的指标、数据和结论都摊开讲,你直接对号入座。
先说一个很多人踩过的坑:把电商运营和数据采集当成同一种需求去买IP。实际测下来会发现,这两类场景要的东西几乎是反着的。
电商运营要的是稳。店铺后台最怕IP环境忽变——上一分钟出口还在苏州,下一分钟变成广州,平台很容易把这种跳动判定成异常登录,轻则弹验证,重则限制操作。所以运营场景需要的是长时间不变、城市归属固定的IP,最好和账号日常登录的地区对得上。
数据采集要的是快和多。爬虫任务面对的是海量页面,单个IP请求频率一高就会被目标网站限流,所以池子里的IP要流转起来,每个IP存活几分钟就完成使命,任务自动获取新的IP接着跑。这个场景对"一个IP能用多久"不敏感,对可用率和提取速度极其敏感。
一句话:运营选长效静态,采集选短效动态。下面分别上实测。
电商运营场景实测:盯了三天,就看这四项
朋友的电商公司有十几个店铺后台,账号归属地分散在苏州、合肥、长沙这类二线城市。测试周期三天,我重点记录四个指标。
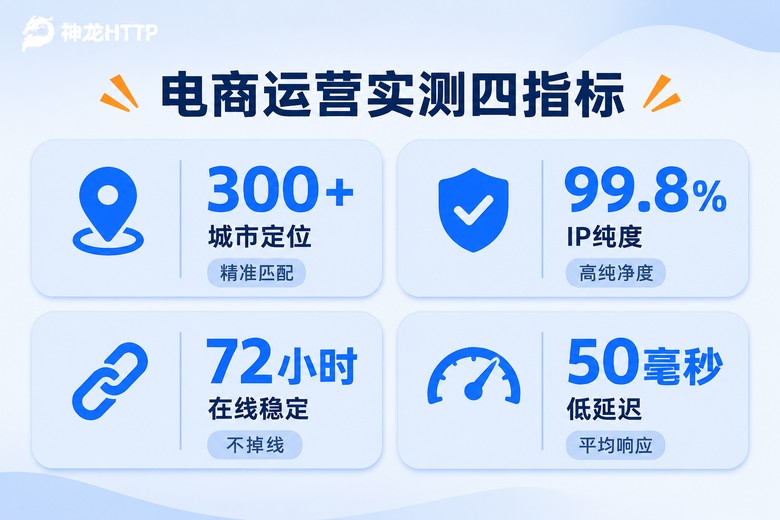
城市定位精准度。不少小服务商号称覆盖全国,实际只有省会资源,苏州、合肥这种城市匹配不到,只能拿邻近省会IP凑合。实测中有一家标称300+城市级定位的服务商,这几个城市都能精确命中,账号环境和日常登录地区完全一致,这一项直接决定了环境像不像"真人"。
IP纯度。纯度说的是这个IP有没有被大量人用过、有没有在目标平台留下过异常记录。我们用后台登录反馈做判断:纯度99.8%的那组,十几个账号连续一周操作,没触发过一次异常验证;对照组里纯度一般的IP,第二天就有一个账号被要求二次校验。
连接稳定性。静态IP挂上之后连续在线72小时,掉线次数为零,重连后归属地不变。这项不过关,前两项做得再好也白搭——IP天天变,等于没有静态。
响应延迟。后台操作对延迟不算苛刻,但实测平均延迟50毫秒以内的服务,上传商品图、改库存明细时明显更跟手,一天操作下来体验差距很直观。
结论:运营场景别省这个钱,长效静态IP加城市级定位是标配,纯度必须看实测而不是宣传页。
数据采集场景实测:两个数字定生死
另一个客户的采集项目更吃性能——每天抓取某电商平台上公开展示的价格和销量信息,页面量级百万起步。这个场景我主要压测两项。
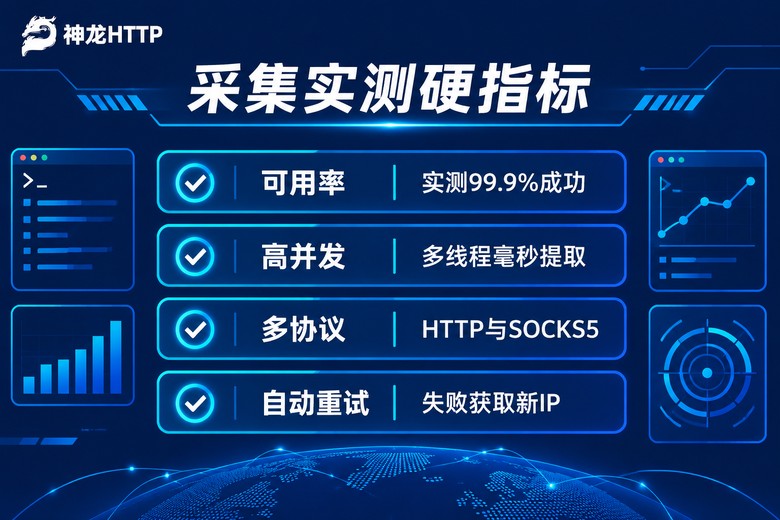
可用率。拿到一批IP后逐个发测试请求,统计正常返回的比例。可用率99.9%的服务商,一万次请求失败个位数,而且失败后自动取新IP重试,任务全程不用人盯。可用率低于95%的服务,重试逻辑写得再精致,整体耗时也会被拖长一大截,还容易在目标网站那边留下失败记录。
并发提取能力。采集是多线程同时跑的,IP提取接口扛不住并发,线程就得排队。实测中,低延迟高并发提取的服务,单机开200个线程同时取IP,接口响应依然在毫秒级;另一家并发一上去就超时排队,整体效率直接腰斩。
还有个容易忽略的细节:协议支持。有些老爬虫框架只认SOCKS5,服务商如果不全支持HTTP/HTTPS/SOCKS5,接入前还得改代码。选型时把这一项提前确认掉,能省不少麻烦。
一张表看懂两类场景的差异
两次实测的结论压缩成一张表,选型时直接对照:
| 对比维度 | 电商运营场景 | 数据采集场景 |
|---|---|---|
| 推荐产品类型 | 长效静态IP / 固定IP代理 | 短效动态IP |
| 单IP在线时长 | 按天计,越久越稳 | 几分钟到几十分钟 |
| 城市定位要求 | 精确到城市 | 一般到省级即可 |
| 核心考核指标 | 稳定性、IP纯度 | 可用率、并发能力 |
| 协议支持 | HTTPS为主 | HTTP/HTTPS/SOCKS5 |
| 失败处理方式 | 尽量零失败 | 靠重试机制兜底 |
动态、静态、固定,别再傻傻分不清
这三个词新手最容易混淆,用大白话讲一遍:
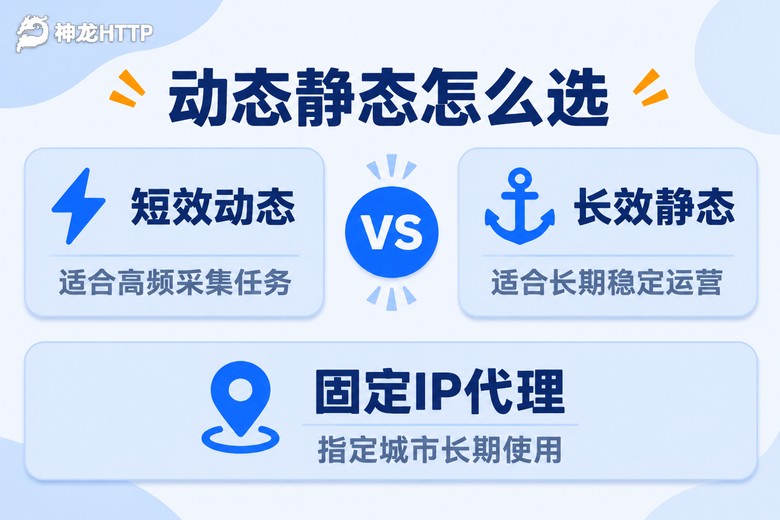
短效动态IP:每次提取都是新IP,存活几分钟到几十分钟,用完即弃。适合采集、价格监测这类高频次任务,单价也最低。
长效静态IP:IP长时间固定不变,适合要保持登录状态、持续操作后台的电商运营场景。
固定IP代理:在静态的基础上还能指定地区,比如就指定苏州的出口。对归属地有硬性要求的业务,选这种。
判断方法就一个问题:"我的任务需要这个IP一直不变吗?"需要,选静态或固定;不需要,动态更划算。
拿到服务先别放量,五分钟做个最小验证
不管选了哪家,拿到提取权限后先跑一遍最小验证,确认连通性和延迟再上真实任务。用Python的话十几行就够:
import requests, time

# 第一步:从服务商后台复制API提取链接,请求一次拿到代理IP
# 提取链接的返回格式见服务商文档,这里以 "ip:端口" 为例
proxy = "113.**.**.**:8080"
proxies = {"http": "http://" + proxy, "https": "http://" + proxy}

# 第二步:把 TEST_URL 换成任意一个能回显出口IP的查询接口
TEST_URL = "http://your-ip-echo-api"

resp = requests.get(TEST_URL, proxies=proxies, timeout=5)
print("当前出口IP:", resp.text)

# 第三步:连测10次,取平均延迟
costs = []
for _ in range(10):
    t0 = time.time()
    requests.get(TEST_URL, proxies=proxies, timeout=5)
    costs.append(round((time.time() - t0) * 1000))
print("平均延迟(ms):", sum(costs) // len(costs))
脚本跑通、平均延迟在可接受范围内,再小规模跑半天真实任务,观察失败率和目标网站的反馈,都没问题再放量。这一步能帮你把"参数好看但实际拉胯"的服务商提前筛掉。
两次实测,最后都落在同一家
两个客户最后用的都是神龙HTTP,原因不是参数表最好看,而是几个实测体验:
电商这边,看中的是300+城市级精准定位和99.8%的IP纯度,苏州、合肥这类城市都能精确匹配,账号环境一周零异常。IP池是3000万+正规授权代理IP储备,来自国内三大运营商的正规授权,来源干净,用着踏实。
采集这边,看中的是99.9%可用率和低延迟高并发提取,百万级页面任务跑下来基本不用人工补位。API兼容主流爬虫编程语言,文档和示例代码齐全,客户的技术同事半天就接完了。中途提取接口出过一次异常,技术团队7×24小时支持,凌晨提的工单二十分钟就有人响应,这点对跑长任务的团队很关键。
另外个人中心的可视化用量统计和实时监控也实用——每天消耗多少、哪个任务异常、趋势怎么走,后台一眼看清,连自己搭监控的功夫都省了。
常见问题
Q:免费代理IP能用于正式业务吗?
实测不建议。免费IP可用率通常不到三成,延迟高、存活时间随机,一次采集任务在失败重试上耗掉的时间,早就超过正规服务的成本了。拿来学习调试可以,业务上别省这个钱。
Q:独享IP和共享IP怎么选?
独享IP只有你一个人用,纯度和稳定性最好,电商运营这类对环境敏感的场景优先选它;共享IP便宜,一般强度的数据采集任务用共享池也够。
Q:提取到的IP一般多久失效?
短效动态IP按套餐不同,存活时间从一两分钟到几十分钟不等;长效静态IP按天计。写程序时记得加两道保险:请求失败自动重试,以及定期重新提取,保证任务不中断。
Q:不太会写代码,能用上代理IP吗?
能。神龙HTTP提供文档和示例代码,主流语言都有现成示例,照着改几个参数就能跑;完全不想碰代码的话,也可以用支持代理设置的现成采集工具,把提取接口填进设置里就行。