先把代理IP池拆成三块:来源、调度、监控
很多团队一开始就盯着“IP够不够”,结果池子搭起来后还是频繁失败。更稳的做法,是把代理IP池当成一个小型服务来设计:IP从哪里来、每次请求拿哪个IP、失败后怎么处理、异常能不能被发现,这四件事都清楚了,池子才不容易乱。
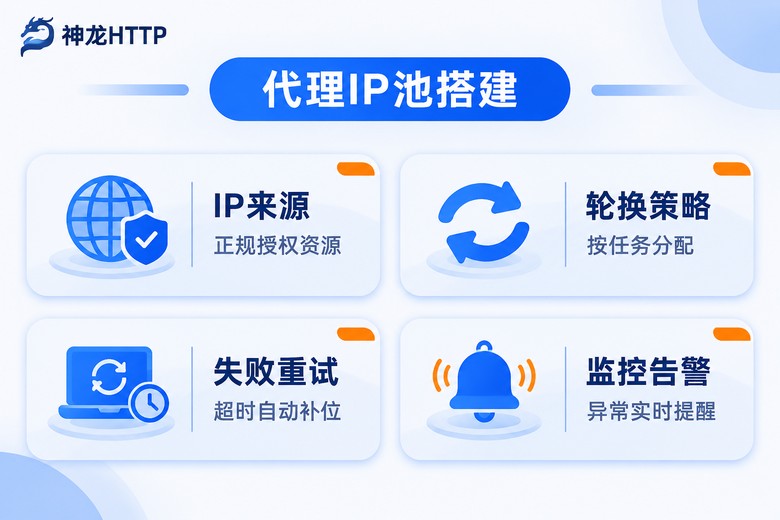
付费代理IP池通常不是“一堆IP字符串”,而是由IP来源层、调度层、监控层组成。来源层负责提供可用IP,调度层决定任务请求走哪个IP,监控层负责记录成功率、延迟、失败原因,并把这些信号反馈给调度层。
如果你做的是公开数据采集、市场研究或AI训练数据准备,建议一开始就记录每个IP的“健康状态”。不要等请求失败很多了才处理,而是让系统知道哪些IP还能用、哪些IP需要冷却、哪些IP该从池子里移出。
IP来源怎么选:先满足任务,再谈数量
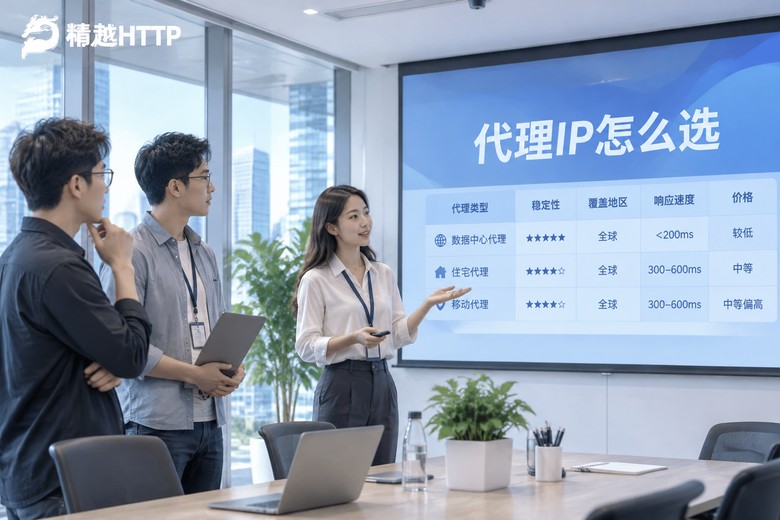
选IP来源时,别只看“数量大”。对爬虫来说,真正影响结果的是可用率、协议支持、定位精度、提取速度。一个IP池如果经常超时,或者只能支持一种协议,后面写重试逻辑就会很被动。
以神龙HTTP为例,它提供3000万+正规授权代理IP储备,并支持HTTP/HTTPS/SOCKS5协议。做代理池时,可以先按任务需求把IP分成几组:一组用于普通页面采集,一组用于需要城市级定位的任务,一组留给高并发场景。这样调度层不用每次都从全量池里“盲选”,而是先选到合适的子池。
如果任务对地区敏感,比如需要按城市维度采集公开信息,就可以把“城市级定位”作为筛选条件。这样拿到的IP更贴近任务目标,后续失败率也会更容易控制。
IP轮换策略:别只按时间轮,要按任务状态轮
很多代理池的轮换逻辑很简单:按顺序取IP,或者随机取IP。短期看没问题,任务一复杂就会暴露问题。比如某个IP连续出现超时,系统还在继续用;某个任务已经失败三次,系统还在换IP重试,最后把资源浪费在无效请求上。
更实用的IP轮换策略,是把“轮换”和“任务状态”绑定。可以按下面几类来设计:
| 轮换方式 | 适合场景 | 优点 | 注意点 |
|---|---|---|---|
| 随机轮换 | 简单采集、低并发 | 实现简单 | 容易重复使用不稳定IP |
| 任务绑定 | 同一任务连续请求 | 状态更稳定 | 单个IP异常要及时退出 |
| 失败冷却 | 超时、连接异常 | 避免无效请求 | 冷却时间要可配置 |
| 城市级定位 | 按城市采集公开信息 | 结果更贴近任务 | 池子要按地区分组 |
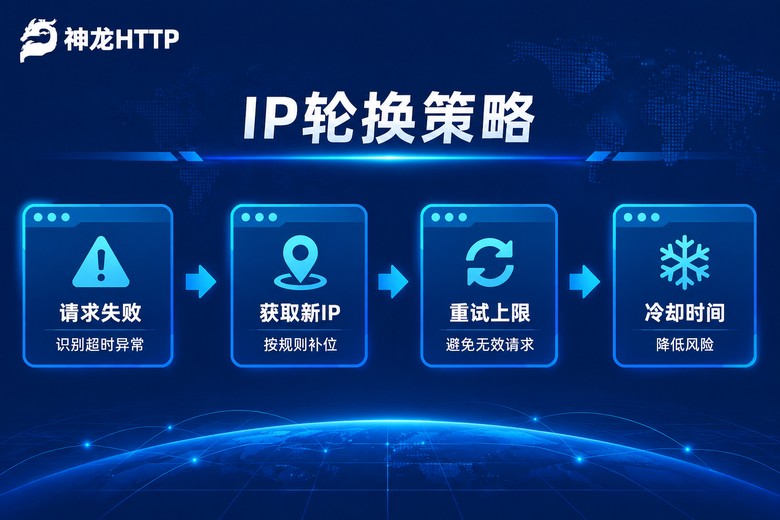
这里的关键不是“轮换越快越好”,而是让每次获取新的IP都有理由。比如任务第一次失败,可以获取新的IP重试;同一个任务连续失败两次,就进入冷却;如果某个地区IP频繁失败,就降低该地区的权重。
失败重试机制:把超时、异常、拦截信号分开处理
失败重试不是“失败就再来一次”。不同失败原因,对应不同处理动作。把失败原因混在一起,很容易出现两个问题:一是该重试的不重试,二是不该重试的反复重试。
建议把失败分成三类:
超时类:请求长时间没有响应,通常说明当前IP链路不稳定。处理方式是获取新的IP,并给旧IP记录一次超时。不要立刻用同一个IP继续试。
异常类:请求返回异常状态、解析失败、连接被拒。这类问题有时是IP本身问题,有时是目标页面结构变化。可以先用新的IP重试一次;如果仍然失败,就要检查代码逻辑,而不是继续换IP。
拦截信号类:请求被拒绝、出现验证码、返回异常页面。这类信号要谨慎处理。可以立刻停止当前任务对该IP的使用,把IP放入冷却池,并降低后续调度权重。连续出现拦截信号时,应暂停任务,先检查请求频率和页面特征。
一个可落地的代理池示例
下面是一个简化示例,重点不是完整生产代码,而是展示“IP池、失败标记、重试上限、冷却时间”四个关键部分。实际项目里,可以把它接到你的调度系统或API网关上。
class ProxyPool:
    def __init__(self, proxies, cooldown_seconds=60, max_retries=3):
        self.proxies = proxies
        self.failed = {}
        self.cooldown_seconds = cooldown_seconds
        self.max_retries = max_retries

    def get_proxy(self):
        import time
        now = time.time()
        healthy = []
        for proxy in self.proxies:
            info = self.failed.get(proxy)
            if info is None or now >= info["retry_at"]:
                healthy.append(proxy)
        if not healthy:
            return None
        return healthy[0]

    def mark_failed(self, proxy, reason, retry_delay=0):
        import time
        self.failed[proxy] = {
            "reason": reason,
            "retry_at": time.time() + max(retry_delay, self.cooldown_seconds),
        }

def request_with_proxy(pool, url, task_id):
    attempt = 0
    while attempt < pool.max_retries:
        proxy = pool.get_proxy()
        if proxy is None:
            return {"ok": False, "error": "no_proxy_available"}
        result = do_request(url, proxy)
        if result["ok"]:
            return result
        pool.mark_failed(proxy, result["reason"], retry_delay=5 * attempt)
        attempt += 1
    return {"ok": False, "error": "retry_exhausted"}
这个示例里有几个细节值得注意:
第一,失败IP不是永久拉黑,而是进入冷却时间。很多IP只是临时波动,冷却一段时间后可以重新参与调度。
第二,重试次数有上限。没有上限的重试,会把失败任务变成持续消耗资源的行为。上限设置要结合任务价值决定,普通采集任务3到5次通常够用。
第三,失败原因要记录。只记录“失败”不够,要记录是超时、连接异常还是页面异常。后面做监控和调参时,这些数据非常有用。
监控不是锦上添花,是代理池的刹车系统
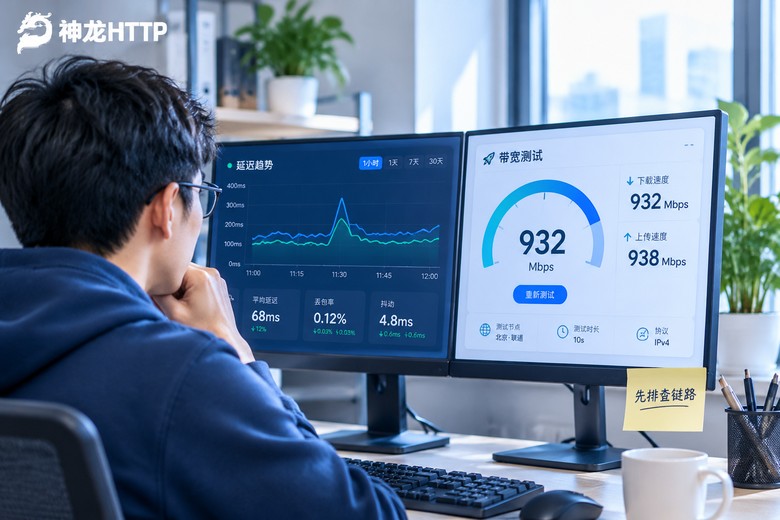
代理IP池跑起来以后,最怕的是“看起来在跑,实际上失败率很高”。监控层至少要看四个指标:成功率、平均延迟、失败原因分布、IP可用数量。这四个指标一旦异常,调度策略就要调整。
例如,成功率从95%掉到80%,不一定是IP池问题,也可能是请求频率过高、目标页面变化、或某个地区IP质量波动。这时候不要盲目增加重试次数,而是先定位失败原因。如果失败集中在某一类IP,就降低该类IP权重;如果失败集中在某个任务,就先暂停任务并检查请求逻辑。
成熟的代理池监控工具,可以把“IP健康状态”和“任务执行状态”放在一起看。对爬虫团队来说,这能减少靠人工翻日志排查的时间,也能让IP轮换和失败重试策略更稳定。
常见问题
Q: 代理IP池一定要很大吗?
不一定。池子大小要和任务并发、失败率、冷却时间匹配。任务并发不高时,少量高质量IP比大量不稳定IP更稳。关键是让调度层能识别哪些IP可用,哪些IP需要冷却。
Q: IP轮换频率越高越好吗?
不是。轮换太频繁会增加连接成本,也可能让任务状态不稳定。更合理的做法是按失败信号和任务状态获取新的IP,而不是无差别地快速轮换。
Q: 失败重试次数应该设多少?
普通公开数据采集任务可以设3到5次。如果任务价值高、失败成本高,可以适当增加,但必须配合冷却时间和失败原因判断,避免无效请求持续消耗资源。
Q: 什么时候该暂停任务?
当同一类失败在短时间内集中出现,或者成功率明显下降、拦截信号增多时,应暂停任务。先检查请求频率、页面结构和IP状态,再决定是否继续。