先弄明白:采集为什么总被拦
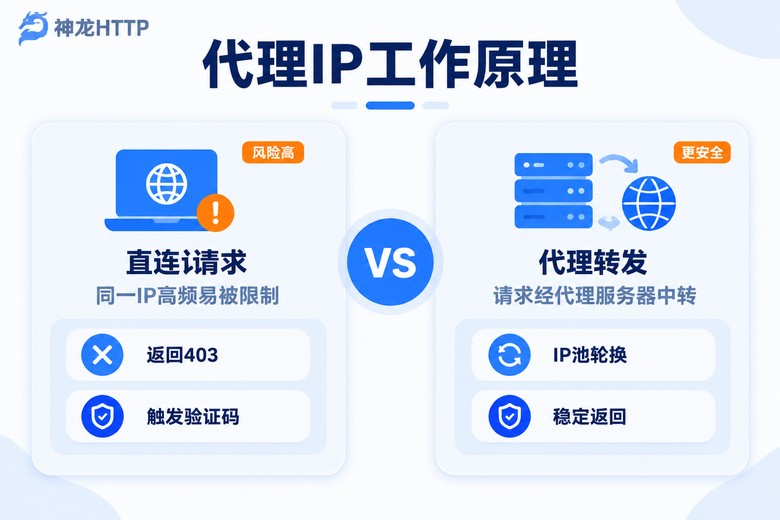
做过采集的人多半见过这种场面:脚本前几百页跑得顺顺当当,突然开始返回403,或者弹出一堆验证码,任务直接卡死。很多人第一反应是改请求头、加延时,折腾半天收效甚微。问题的根源其实很简单——你一直用同一个IP在高速请求,对方的风控系统不拦你拦谁。
网站判断访问是否正常,主要看三个信号:请求频率是不是超出正常人的操作范围、同一个IP短时间内发起了多少请求、这个IP的历史记录干不干净。真人浏览是翻一页点一下,一分钟也就十几次请求;采集脚本一秒能发几十上百个,还全从同一个IP出去,特征太明显了。
代理IP的作用,就是在你和目标网站之间加一层中转。请求先发到代理服务器,由它代替你去访问目标站,网站看到的是代理的IP地址。配合一个足够大的IP池轮着用,每个IP承担的请求量被摊薄,风控自然难以触发。
实战四步:把代理IP真正用出效果
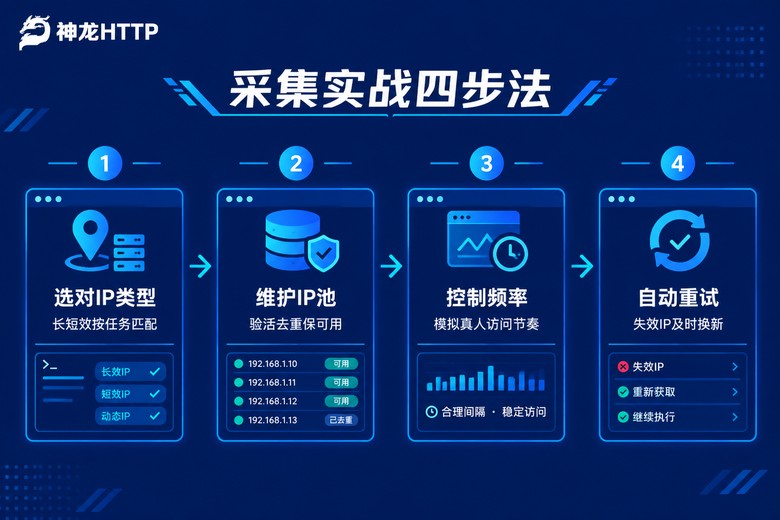
代理IP不是买来接上就能用的,一个任务能不能稳定跑完,取决于下面四步做得细不细。
第一步,按任务选IP类型。短效动态IP生命周期短,几分钟到几十分钟不等,胜在量大、成本低,适合需要频繁获取新IP的采集任务;长效静态IP能稳定用很久,适合需要登录状态、会话保持的场景。类型选错,任务跑一半IP全过期,重试逻辑写得再好也白搭。
第二步,把IP池管起来。拿到一批代理IP后,先验活再入库:发一个轻量请求测连通性和响应速度,超时或者状态码异常的直接踢掉。池子要定期补充新IP、淘汰旧IP,保证任一时刻可用的数量够任务消耗。这一步偷懒,后面报错会成倍还给你。
第三步,控制请求频率。就算换了IP,也不能拿一秒一百次的频率去怼人家服务器。给每个IP设合理的并发上限,请求之间加随机延时,比如在0.5到2秒之间取随机数,让访问节奏看起来更像真人。对方服务器没压力,你的任务也跑得久。
第四步,做好失败重试。IP失效是常态,不是异常。请求失败后自动标记这个IP、换池子里的下一个重试,重试两三次还不行就换新的IP进来。把这套逻辑写进代码,任务才不会因为单个IP掉线而中断。
import requests
import random
import time

# 从代理服务商API提取的IP列表
proxy_pool = [
    "http://用户名:密码@ip地址1:端口",
    "http://用户名:密码@ip地址2:端口",
    "http://用户名:密码@ip地址3:端口",
]

def fetch(url, max_retry=3):
    for _ in range(max_retry):
        proxy = random.choice(proxy_pool)
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=10,
                headers={"User-Agent": "Mozilla/5.0"}
            )
            if resp.status_code == 200:
                return resp.text
        except Exception:
            pass  # 这个IP失效,换个IP重试
        time.sleep(random.uniform(0.5, 2))  # 随机延时
    return None

print(fetch("https://example.com/data?page=1"))
这段是最简骨架,生产环境还要加上IP池自动补充、异常计数、日志记录。如果不想从零搭,神龙HTTP的API兼容主流爬虫编程语言,文档里带现成示例代码,把提取到的IP接进上面的框架就能跑,技术团队7×24小时在线,卡住了有人管。
不同采集场景,选型思路不一样
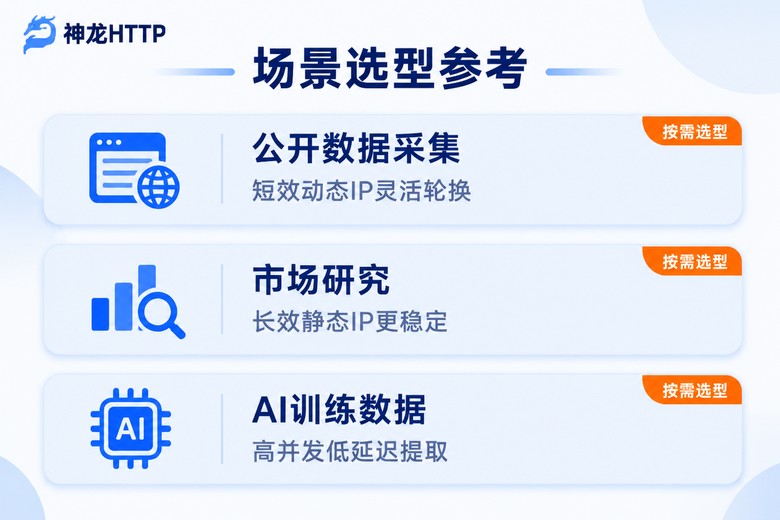
同样是数据采集,场景不同,IP策略差别很大。下面这张表是实际项目里反复验证过的选型参考:
| 场景 | 推荐类型 | 原因 |
|---|---|---|
| 公开数据采集 | 短效动态IP | 量大成本低,频繁获取新IP不易被盯上 |
| 市场研究与比价 | 长效静态IP | 会话稳定,前后数据口径一致 |
| AI大模型训练数据准备 | 短效动态IP+高并发 | 数据量大,低延迟高并发提取省时间 |
| 需要固定出口的业务 | 固定IP代理 | 出口长期不变,便于对方白名单放行 |
还有一个容易被忽略的维度:IP质量。同样是代理IP,有的池子里混着大量被标记过的地址,一用就触发验证;有的纯度高,拿去就能用。判断质量看两个硬指标——可用率和纯度。像神龙HTTP的可用率做到99.9%、IP纯度99.8%,覆盖300多个城市级精准定位,需要采集某个特定地区的数据时,直接指定城市提取就行,不用碰运气。
合规提醒:这几条底线别踩
技术问题解决了,合规这关过不去,项目照样做不长。动手之前,把这四条过一遍:
只采公开数据。目标网站公开展示、无需登录就能看到的信息,采集风险最低。需要登录才能看的内容、页面明确标注禁止抓取的内容,先拿到授权再动手,别抱侥幸心理。
看一眼robots协议。目标网站根目录下的robots.txt写明了哪些路径允许抓取、哪些不允许。花一分钟看一眼,能避开大部分不必要的麻烦。
别把对方服务器搞挂。控制频率不只是为了防风控,也是基本的网络礼仪。发现响应明显变慢就主动降低并发,别只顾自己的任务进度。
不碰个人信息。采到的数据如果包含姓名、手机号这类个人信息,存储和使用要符合个人信息保护法的要求,做好脱敏,别超范围使用。
另外提醒一句:代理服务商本身的资质同样关键。用来源不明的代理,等于把你的请求流量交给陌生服务器中转,安全没有保障。神龙HTTP的IP来自国内三大运营商正规授权,来源干净可查,真遇到合规审查,这一点能省下很多解释成本。
常见问题
Q: 免费代理能用吗?
偶尔应急可以,正经项目别用。免费代理可用率低、速度慢,而且你不知道那台服务器是谁在运营,请求内容存在被截取的风险。商业项目建议用正规授权的付费服务,成本不高,省下的排查时间远超差价。
Q: 一个任务大概需要多少IP?
取决于目标网站的限制强度。限制松的站,几十个IP轮换就能跑完;风控严的站,可能要几百上千个。建议先小规模试跑,记录单个IP大概能承受多少请求再被限制,用总数据量一除就能估出来。
Q: 用了代理IP,采集速度会变慢吗?
会有一点额外延迟,因为请求多了一跳中转。但正规服务商的线路延迟很低,配合高并发提取,整体吞吐反而比单IP串行快得多。如果发现某个代理明显拖慢速度,把它踢出池子换一个就行。
Q: 怎么判断代理服务商靠不靠谱?
看三个硬指标:可用率、纯度、响应速度,再补一个软指标——用量透不透明。神龙HTTP的个人中心有可视化用量统计和实时监控,用了多少、成功率多少、有没有异常一目了然,出问题能快速定位,这比口头承诺实在得多。