别急着下结论,先把"慢"定位到具体环节
经常有朋友拿着截图来问:同样的采集脚本,不挂代理每分钟能跑两百多次,挂上代理直接掉到三十次,是不是代理IP不行?
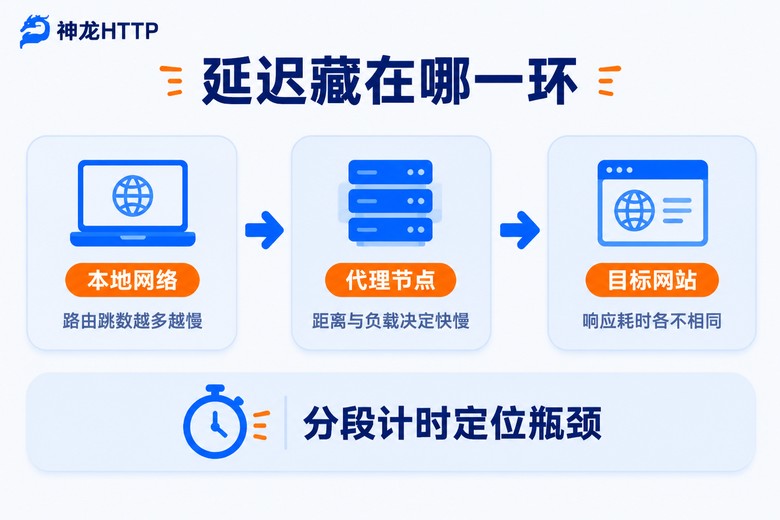
先说一个基本事实:挂代理之后速度有轻微下降是正常的,毕竟中间多了一道中转。但如果慢到难以接受,九成以上不是"代理"这个技术本身的问题,而是链路上某一环出了状况。一个请求从你的电脑出发,要经过本地网络、代理服务器,最后才到目标网站,三段路里任何一段堵了,你感受到的都是同一个字——慢。所以排查的第一步不是换服务商,而是把这三段拆开,逐段计时。
最省事的办法是用 curl 自带的计时参数,一条命令就能看清每个阶段花了多久:
curl -x "http://用户名:密码@代理地址:端口" -o /dev/null -s -w "
DNS解析:   %{time_namelookup}s
建立连接:  %{time_connect}s
SSL握手:   %{time_appconnect}s
首字节:    %{time_starttransfer}s
总耗时:    %{time_total}s
" https://你要访问的目标地址
拿到这组数字,问题基本就现形了:建立连接耗时长,多半是节点离你太远;SSL握手拖后腿,是协议层面的开销;首字节等待久,可能是目标网站在"琢磨"你这个IP。下面把每种情况挨个拆开讲。
原因一:节点离得太远,路途上的延迟省不掉
数据在网络里跑得再快也受物理距离限制。你在广州,提取的节点却落在东北,一个来回就凭空多出几十毫秒。单看一次请求,几十毫秒好像无所谓,可采集任务动辄几千上万个请求,累加起来差距就很扎眼了——原本两小时能跑完的任务,拖到半天都不稀奇。
还有个更隐蔽的情况:绕路。你的请求先从广州跑到北京的节点,节点再转回深圳去连目标网站,直线距离明明很近,链路却画了个大三角。这种时候光看节点位置没用,得靠实测。
解决办法很直接:提取IP的时候,优先选离自己近、或者离目标网站服务器近的城市节点。像神龙HTTP支持300+城市级精准定位,提取时可以直接指定城市,把路途延迟这一项压到最低。验证方法也简单,挑几个不同城市的节点分别测一下延迟,差距一目了然。
原因二:一个IP挤了太多人,高峰期谁都快不起来
这是共享IP池绕不开的问题。一个IP同时被很多人使用,出口带宽就要摊到每个人头上,赶上晚高峰,速度掉一半是常事。更麻烦的是IP"用旧了"——被目标网站盯上之后,返回的不再是正常页面,而是验证页或者干脆限速,你的脚本看似在跑,实际效率已经大打折扣。
判断是不是这个原因,有个土办法但很管用:挑凌晨和晚上八点两个时段,用同一个节点分别测速。如果晚上的速度明显掉下去,基本可以确定是负载问题。
对应的解法有两个方向。一是提高提取频率,别在一个IP上死磕,短效动态IP每次提取都是新IP,被限速了就重新提取一批,始终用"新鲜"的IP干活;二是把好质量关,纯度高的IP意味着用的人少、更干净,神龙HTTP的IP纯度做到99.8%、可用率99.9%,从源头上减少了拿到"疲IP"的概率。
不同类型的IP,速度表现差别不小,选之前可以先对照一下:
| IP类型 | 速度表现 | 适合的场景 |
|---|---|---|
| 短效动态IP | 每次都是新IP,不易被限速,整体吞吐高 | 请求量大、频率高的采集任务 |
| 长效静态IP | 稳定,但用久了容易被目标网站"记住" | 需要维持会话状态的业务 |
| 独享型IP | 带宽独占,速度最稳 | 对响应速度敏感的项目 |
原因三:协议和认证方式没选对,时间耗在了流程上
同样是走代理,HTTPS要比HTTP多一次握手,SOCKS5工作在更底层、开销更小。目标网站如果没有强制要求,选对协议能省下实打实的时间。挑服务商的时候留意是否三种协议都支持(HTTP、HTTPS、SOCKS5),按需选择就行。
认证方式也有讲究。账号密码认证,每次建立连接都要多一道验证;如果服务商支持IP白名单认证,提前把自己服务器的IP加进去,连接时少一步验证,在高频请求下省出来的时间很可观。这个细节知道的人不多,但确实影响速度。
原因四:你的代码,可能才是最大的瓶颈
前面三条都排除了还是慢?那得回头看看自己的代码了。这几个写法问题特别常见:
一是请求串行跑。一个接一个地发请求,每个都要等上一个返回。改成并发,10个线程同时跑,速度直接翻几倍。
二是不复用连接。每发一个请求都重新建连、重新握手,白白多花时间。用 Session 把连接复用起来,省的不只是时间,还有节点的资源。
三是超时设得太长。有的朋友把超时设成60秒,碰到一个卡住的请求,整个队列都得跟着等。超时设短一点,比如3到5秒,失败了马上重试下一个,整体效率反而更高。
把这三点改掉,效果立竿见影。给一段可以直接抄的示例:
import requests
from concurrent.futures import ThreadPoolExecutor

# 用 Session 复用连接,避免每次请求都重新握手
session = requests.Session()
session.proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口"
}

def fetch(url):
    try:
        # 超时设短,快速失败,别让慢请求拖住队列
        resp = session.get(url, timeout=(3, 5))
        return resp.status_code
    except Exception:
        return None

urls = ["https://目标地址/page1", "https://目标地址/page2"]

# 并发执行,比串行快一个量级
with ThreadPoolExecutor(max_workers=10) as pool:
    results = list(pool.map(fetch, urls))

success = sum(1 for r in results if r == 200)
print(f"成功 {success} / {len(urls)}")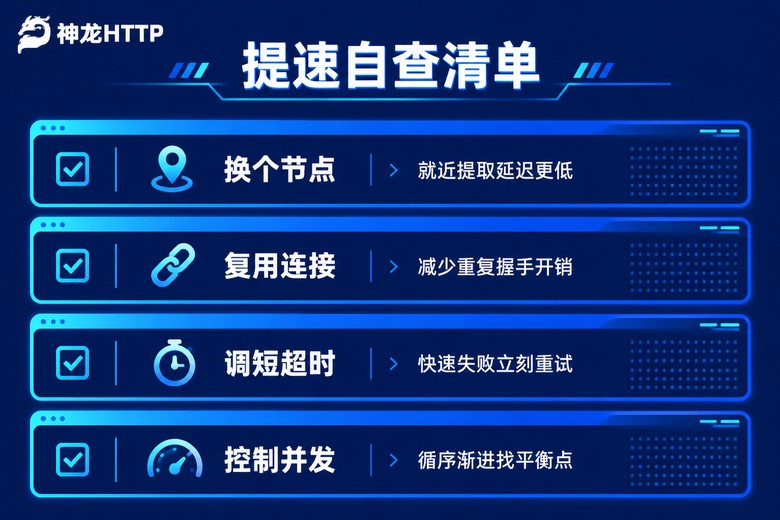
与其事后补救,不如一开始就选对服务商
说实话,上面这些排查动作每次都做一遍,也挺耗精力的。更省心的思路是:选一个在速度上下过功夫的服务商,让很多问题从源头上就不出现。
拿神龙HTTP来说,有两点对"快"这个字帮助最大。一是低延迟高并发提取,IP资源基于国内三大运营商正规授权,3000万+的储备量摆在那,高并发场景下提取IP依然跟手,不用排队等资源;二是个人中心里的可视化用量统计和实时监控,成功率、耗时这些指标直接看图表,哪个时段慢、哪类请求异常,一眼就能看出来,不用自己搭监控再写脚本算。
另外它兼容主流爬虫编程语言的API,文档里带示例代码,接进现有项目基本是复制粘贴的事。真遇到解决不了的问题,技术团队7×24小时在线,不用自己对着报错信息干熬。
常见问题
Q: 免费的代理IP为什么普遍很慢?
免费意味着用的人多,一个IP背后挤着大量用户,带宽被摊得极薄,而且IP质量参差不齐,很多早就被目标网站标记了。拿它应急测试可以,正经跑任务还是建议用付费的正规服务,速度和稳定性完全不是一个量级。
Q: 并发数开得越高,跑得就越快吗?
不是。并发太高,一方面节点负载上去了、单次请求变慢,另一方面容易触发目标网站的保护机制,成功率反而往下掉。建议从小并发起步,比如5到10,观察成功率和速度,再逐步往上加,找到那个平衡点。
Q: 怎么判断是该重新提取IP,还是该换服务商?
做个交叉测试:从同一个服务商多提取几个不同地区的节点,分别测速。如果个别节点慢、其他正常,那是节点的问题,重新提取就行;如果所有节点都慢,而且换个时段测也一样,那大概率是服务商本身的问题,该考虑换一家了。
Q: 测速工具显示的速度和实际使用差距很大,正常吗?
正常。测速工具测的是到节点之间的裸速度,实际使用还叠加了目标网站的响应时间和你的代码处理耗时。所以判断代理快不快,最好用真实业务场景去测,比如统计一批真实请求的总耗时和成功率,那才是有效数据。