去年帮朋友排查一个数据聚合服务,程序逻辑没毛病,就是出口一直是服务器自己的那一个IP。跑得久了,目标站开始挑理:先限速,后来干脆半天不响应。当时做的决定是:别在程序里折腾代理逻辑了,把出口IP自动轮换这件事上移到nginx层,程序一行代码不用改。后来这套配置稳定跑了一年多,中间只调过两次参数。下面按当时的操作顺序写出来,每一步都能直接照抄。
动手前,先把三样东西备齐
需要准备的东西不多,三样。
一台装好nginx的服务器。版本别太老,1.16以上就行,执行 nginx -v 看一眼,变量转发、平滑reload这些写法在老版本上容易出兼容问题。
一份能正常提取的动态IP。下面都以神龙HTTP的短效动态IP为例:在个人后台生成一条提取链接,返回格式选纯文本、每行一个IP:端口(具体选项以后台为准),单次提取量按业务量定,比如一次50个。
授权。把服务器的公网IP按服务商要求绑定好,不然提取接口会直接拒绝请求,这是新手最常撞的第一堵墙。
备齐之后先验一下提取链接通不通:
nginx -v
# nginx version: nginx/1.24.0

curl "你的提取链接"
# 113.120.61.36:8000
# 183.164.250.11:8000
# 223.240.80.52:8000
能吐出IP列表,准备工作就算完了。
第一步:用一个固定IP把链路跑通
很多人一上来就把动态池、定时任务全堆上去,出了问题分不清是配置写错了还是IP本身不行。正确顺序是先拿一个固定IP把链路打通,排错半径小。新建 /etc/nginx/conf.d/proxy-test.conf:
upstream proxy_pool {
    server 113.120.61.36:8000 max_fails=3 fail_timeout=30s;
}

server {
    listen 8187;

    location / {
        proxy_pass http://proxy_pool;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_connect_timeout 5s;
        proxy_read_timeout 15s;
    }
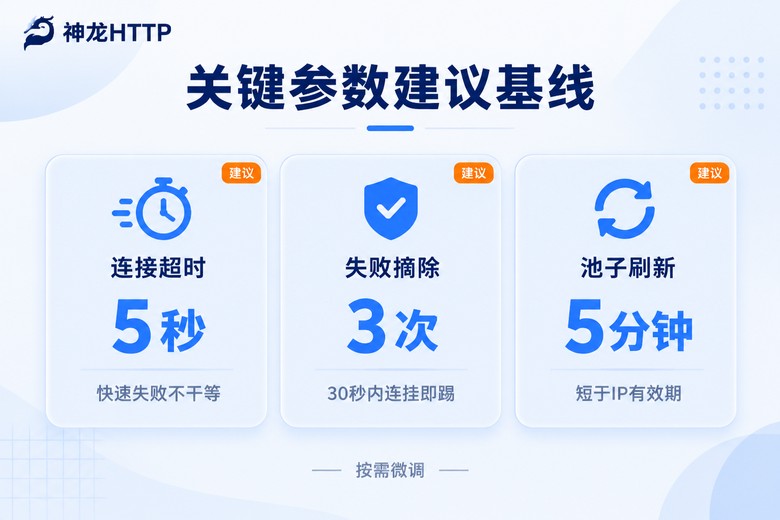
}几个关键点说清楚:8187是网关端口,业务程序以后所有请求都发到这里,不再关心出口是谁。upstream里的server就是代理节点,max_fails=3 和 fail_timeout=30s 的意思是:30秒内连挂3次,这个节点被临时请出池子。proxy_set_header Host $host 这行别删,代理节点靠Host头识别你要访问哪个目标站,写死了所有请求都会跑到同一个站去。
检查并加载:
nginx -t
# nginx: configuration file ... test is successful

nginx -s reload
找个回显服务验证,比如 httpbin.org,它会把收到请求的来源IP原样返回:
curl -s "http://127.0.0.1:8187/get" -H "Host: httpbin.org"返回JSON里的origin字段显示的是代理IP而不是服务器自己的IP,链路就通了。这里如果不通,八成是两件事:授权没绑对,或者接入格式跟服务商要求的不一致——神龙HTTP的文档里有各种语言的接入示例代码,对着改一行就好。
此时整条链路是:业务程序 → nginx网关(8187) → 代理节点 → 目标网站。看一眼图更直观:

第二步:把固定IP换成会自动刷新的动态池
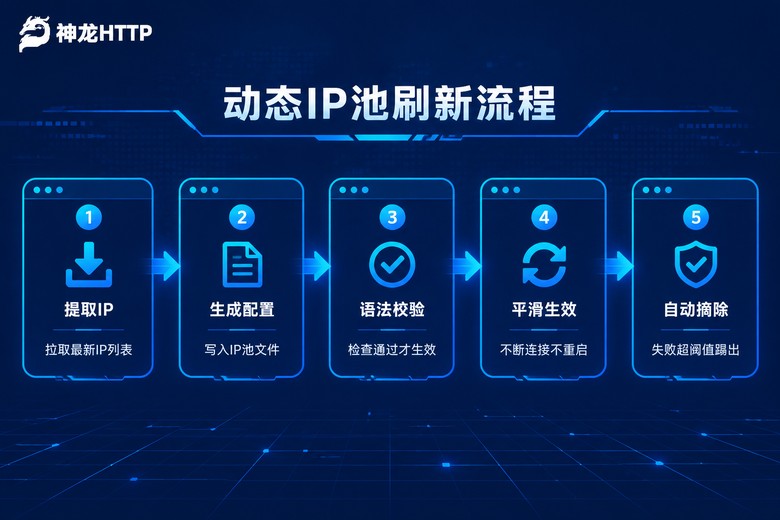
短效动态IP的"短效"两个字是重点:提取出来的IP有有效期,短的几分钟,长的几十分钟,过期就废。所以池子必须有人管——定时拉新IP、重写配置、平滑生效。这件事交给一个十几行的脚本就够了。新建 /opt/scripts/refresh_pool.sh:
#!/bin/bash
API_URL="你的提取链接"
POOL_FILE="/etc/nginx/conf.d/proxy_pool.inc"
LIST="/tmp/proxy_list.txt"

# 拉新IP,每行一个 ip:端口
curl -s --max-time 10 "$API_URL" > "$LIST"

# 拉不到就退出,沿用旧池子,服务不受影响
[ -s "$LIST" ] || exit 1

# 生成新的upstream片段
{
  echo "upstream proxy_pool {"
  awk '{print "    server "$1" max_fails=3 fail_timeout=30s;"}' "$LIST"
  echo "}"
} > "$POOL_FILE"

# 校验通过才生效,reload是平滑的,不断已有连接
nginx -t && nginx -s reload
主配置改成引用这个片段,/etc/nginx/conf.d/dynamic-proxy.conf:
include /etc/nginx/conf.d/proxy_pool.inc;

server {
    listen 8187;

    location / {
        proxy_pass http://proxy_pool;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_connect_timeout 5s;
        proxy_read_timeout 15s;
        proxy_next_upstream error timeout http_502 http_504;
        proxy_next_upstream_tries 2;
    }
}
注意upstream的定义挪进了 proxy_pool.inc,主配置里不再重复写,不然 nginx -t 会报 duplicate 错。接着加进定时任务,每5分钟刷一次:
chmod +x /opt/scripts/refresh_pool.sh
crontab -e
# 添加这一行
*/5 * * * * /opt/scripts/refresh_pool.sh >> /var/log/pool_refresh.log 2>&1刷新周期一定要短于IP有效期。IP能活10分钟,就5分钟刷一次,让新旧两批IP在时间上有一段重叠;卡着有效期刷,池子容易出现几秒钟的空窗,请求恰好撞上就报错。整个流程跑起来是这样的:
第三步:超时和重试参数,一次调到位
动态IP和固定IP最大的区别是质量不均匀——同一个池子里,有的节点快有的慢,个别的是纯坏节点。参数要按"快失败、快换下一个"的思路调,别让单个坏IP拖死整个请求。
| 参数 | 建议值 | 一句话解释 |
|---|---|---|
| proxy_connect_timeout | 5s | 跟代理节点建连的等待上限,动态IP质量参差,不值得久等 |
| proxy_read_timeout | 15s | 等目标站返回数据的上限,目标页面慢就适当放宽 |
| max_fails / fail_timeout | 3次 / 30s | 30秒内连挂3次,节点被临时请出池子 |
| proxy_next_upstream | error timeout http_502 http_504 | 当前节点失败,自动换池子里下一个接着试 |
| proxy_next_upstream_tries | 2 | 最多换2次,防止坏节点扎堆时请求被无限拖长 |
这套值是按网页类请求给的基线。如果你的业务是拉接口数据、响应普遍在1秒内,connect超时压到3s体感更好;反过来要等长响应,read超时放宽到30s。先照基线跑两天,看日志再微调,比凭空拍数字靠谱。
第四步:验证出口IP真的在轮换
配置完必须亲眼看到IP在变,别凭感觉认为它生效了。连发几次请求,看出口:
for i in 1 2 3 4 5; do
  curl -s "http://127.0.0.1:8187/get" -H "Host: httpbin.org" | grep -o '"origin": "[^"]*"'
  sleep 1
done
池子里有多个节点时,这5次请求会轮着走不同IP,origin字段一路变过去就对了。等下一个刷新周期过后再跑一遍,会换上全新的一批。
再看日志。在log_format里加上 $upstream_addr 和 $upstream_response_time 两个字段,哪个IP慢、哪个IP挂,一目了然:
log_format proxy_log '$remote_addr [$time_local] "$request" '
                     '$status upstream:$upstream_addr '
                     'rt:$request_time urt:$upstream_response_time';
最后一层保险交给服务商后台。神龙HTTP个人中心里有可视化用量统计和实时监控,提取量、异常提醒、使用趋势都能直接看到。哪天发现成功率往下掉,先别怀疑nginx,去看脚本日志是不是没跑起来、提取接口是不是返回空了,九成问题出在这两处。
这几个坑,提前知道能省两小时
1. 用reload,别用restart。nginx -s reload 平滑加载新配置,已有连接不断;习惯性 service nginx restart 的话,高峰期每次刷新都会闪断一下。脚本里写死reload。
2. 池子文件别手改。proxy_pool.inc 是脚本生成的,手改的内容会在下一个刷新周期被覆盖。要调参数,改脚本里awk那一段模板。
3. 网关端口别对公网开放。8187只服务自己人,防火墙把公网访问关掉,或者干脆 listen 127.0.0.1:8187 只听本机,不然等于把代理池开放给了路人。
4. 提取接口别硬拉。脚本里那句 [ -s "$LIST" ] || exit 1 就是兜底:这次没拉到,沿用旧池子,下个周期再试。千万别写成拉不到就清空池子,那等于自己把服务打挂。
5. Host头按实际业务传。固定访问一个站可以写死;要访问多个站,就让客户端把目标域名带过来、$host透传,别所有请求挤在同一个Host上。
最后说两句选IP的事。这套方案里,池子质量直接决定转发质量,服务商尽量选正规授权的——神龙HTTP的IP来自国内三大运营商正规授权,99.9%的可用率配合300多个城市的定位精度,做城市颗粒度的定向也够用。文档和示例代码给得全,技术支持是7×24小时的,半夜出问题也有人应。
常见问题
Q:nginx自己能不能定时更新上游IP,不靠脚本?
不能。nginx原生没有"定时更新上游列表"的机制,变量加resolver的写法只能跟随域名解析变化,做不了IP池轮换。外部脚本配合是标准做法,十几行shell就够了,别在这个问题上硬抠nginx本体的功能。
Q:目标站是HTTPS的,这套配置还管用吗?
HTTP请求走上面的配置没问题。HTTPS走代理一般是CONNECT隧道方式,nginx原生对它的支持有限,通常需要额外模块。更省事的做法是HTTPS的请求在程序里直接挂代理——神龙HTTP支持HTTP/HTTPS/SOCKS5三种协议,SOCKS5在代码里配一行就能用,nginx这层专心管HTTP的统一转发。
Q:池子里总有几个IP连不上,正常吗?
正常,动态IP天然有损耗。配置里已经布了三道防线:max_fails自动摘除坏节点、proxy_next_upstream自动换下一个重试、脚本刷新时nginx -t校验不过就不生效。三层兜底之后,个别坏IP对业务基本无感。如果坏IP比例明显偏高,先检查是不是刷新周期太长,池子里堆了太多过期节点。
Q:配完之后出口IP没变,先查哪里?
按顺序查三样:授权,服务器的公网IP有没有按服务商要求绑定好;提取格式,返回的是不是每行一个IP:端口;刷新周期,是不是池子里的IP已经过了有效期还没轮到下次刷新。绝大多数"IP不变"的问题都出在这三处,从前往后排查,两分钟内能定位。