写爬虫的人几乎都遇到过这个场景:脚本昨晚还跑得好好的,今天一启动,满屏403和验证码。原因不复杂——同一个IP短时间内请求了几百次,对方直接把你拉黑了。
破解思路也很直白:别让所有请求都从一个IP出去,准备一堆IP轮着用。这一堆IP,就是常说的代理IP池。这篇文章带你从零写一个能跑的池子,所有代码贴下来就能用,只要装好了requests库,全程十几分钟。
先搞懂原理:IP池其实就四个动作
很多人觉得"池"这个字很玄,把它想成一箱备用门禁卡就好理解了:每张卡都能开同一扇门(访问目标网站),但卡会过期,所以你得不断补充新卡、扔掉失效的旧卡。程序每次发请求前,从箱子里随机摸一张出来用。
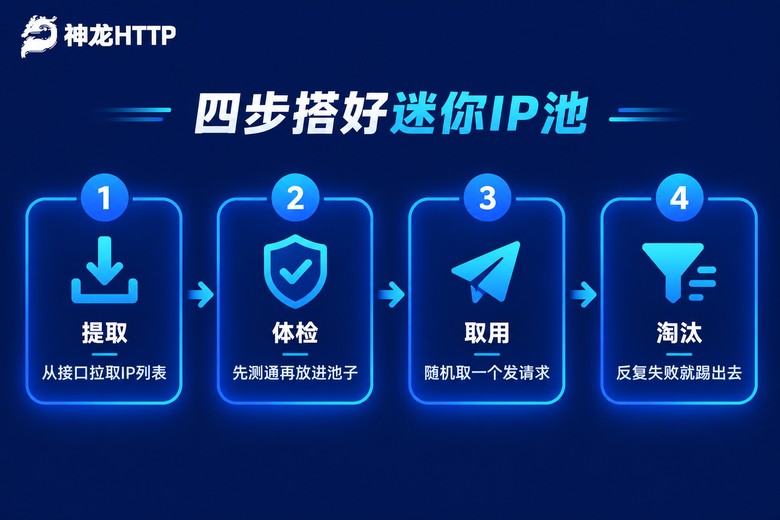
拆开看,一个IP池只做四件事:存(新IP检测通过后放进池子)、取(每次请求随机拿一个)、评(用得好加分,用坏了扣分,扣光就扔)、补(池子快空了自动去提取新IP)。后面所有代码,都是围绕这四个动作展开的。

第一步:十行代码,先让请求走通代理
别急着搭池子,先确认单次代理请求能通。装好库:
pip install requests然后抄这段:
import requests

# 代理IP格式为 "IP地址:端口",从你的代理商后台复制
proxy_ip = "117.68.196.53:4256"

proxies = {
    "http": f"http://{proxy_ip}",
    "https": f"http://{proxy_ip}",
}

# httpbin.org/ip 会返回这次请求的出口IP,拿来验证代理是否生效
resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())
运行后如果打印出来的origin不是你本机的宽带IP,说明代理已经生效。新手在这里常犯两个错:一是忘了写timeout,网络一抖程序就卡死;二是把https的代理地址写成https://开头,实际上统一用http://开头就能正常隧道转发,照抄上面的写法最稳。
第二步:把零散的IP攒成一个池子
单次能通之后,开始攒池子。下面这个类不到40行,存、取、评三个动作全有了,直接复制进你的项目:
import random

class SimpleIPPool:
    """最小可用的代理IP池:存、取、评"""

    def __init__(self):
        self.ips = set()    # 集合存IP,自动去重
        self.scores = {}    # 每个IP的分数,满分100

    def add(self, ip):
        """新IP入库,初始100分"""
        self.ips.add(ip)
        self.scores[ip] = 100

    def get(self):
        """随机取一个IP,池子空了返回None"""
        return random.choice(list(self.ips)) if self.ips else None

    def mark_success(self, ip):
        """请求成功加10分,封顶100"""
        self.scores[ip] = min(self.scores.get(ip, 100) + 10, 100)

    def mark_failed(self, ip):
        """失败扣30分,扣到0踢出池子"""
        self.scores[ip] = self.scores.get(ip, 100) - 30
        if self.scores[ip] <= 0:
            self.ips.discard(ip)
            self.scores.pop(ip, None)

    def size(self):
return len(self.ips)评分机制是这个池子的灵魂。IP这东西说挂就挂,上一秒能通下一秒就失效,靠人工盯着不现实,就让分数替你盯:连续失败三次自动出局,偶尔失败一次的IP还有机会翻身。逻辑简单,但实测能把采集成功率从六七成拉到九成以上。
第三步:给池子加上体检和补货
有了骨架,还差两个动作:入库前体检、存量不足时补货。先写体检函数——新提取的IP里总有一部分测不通,不筛就直接入池,等于往箱子里塞废卡:
import requests

def check_ip(ip, timeout=5):
    """发一个轻量请求,测这个IP当前能不能用"""
    proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
    try:
        resp = requests.get("https://httpbin.org/ip",
                            proxies=proxies, timeout=timeout)
        return resp.status_code == 200
    except requests.RequestException:
        return False
再把主流程串起来,完整跑一次:
import time

pool = SimpleIPPool()

# 假设这是你从提取接口拿到的一批IP
raw_ips = [
    "117.68.196.53:4256",
    "183.164.239.27:4231",
    "119.57.112.101:4232",
    "36.7.108.200:4257",
]

# 入池前先体检,测不通的直接丢弃
for ip in raw_ips:
    if check_ip(ip):
        pool.add(ip)
        print(f"{ip} 体检通过,已入库")
    else:
        print(f"{ip} 测不通,丢弃")

# 模拟连续采集10个页面
for page in range(1, 11):
    ip = pool.get()
    if ip is None:
        print("池子空了,该补货了")
        break

    proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
    try:
        resp = requests.get("https://httpbin.org/ip",
                            proxies=proxies, timeout=10)
        pool.mark_success(ip)
        print(f"第{page}页采集成功,当前IP:{ip}")
    except requests.RequestException:
        pool.mark_failed(ip)
        print(f"IP {ip} 本次失败,已扣分")

    time.sleep(1)  # 控制节奏,别把对方服务器压垮
跑一遍,你能清楚看到每个IP入库、使用、扣分的全过程。到这里,一个能用的IP池就算成型了。
第四步:接上稳定的IP来源,池子才真正能打
自建池子绕不开一个现实问题:IP从哪来?网上的免费列表不是不能用,而是存活时间太短,往往你刚测通、写进任务里就挂了,补货速度永远追不上失效速度。
正经做采集,建议直接对接服务商的提取接口。以神龙HTTP为例,在后台拿到你的专属提取链接(具体入口看它的文档和示例代码),十几行代码就能把补货自动化:
import requests

# 把你的专属提取链接贴到这里
API_URL = "你的提取链接"

def fetch_ips():
    """从神龙HTTP提取一批新IP"""
    resp = requests.get(API_URL, timeout=10)
    # 接口按行返回IP,直接切分就是列表
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def refill(pool, min_size=5):
    """可用IP低于阈值就自动补货"""
    if pool.size() < min_size:
        for ip in fetch_ips():
            if check_ip(ip):
                pool.add(ip)
        print(f"补货完成,当前池子大小:{pool.size()}")
用法简单:在采集循环开头加一行 refill(pool),池子低于5个可用IP就自动拉新货。选服务商时重点看两个硬指标:一是可用率,神龙HTTP标称99.9%,配合上面的评分淘汰机制,基本不会出现任务跑到一半池子集体失效的尴尬;二是储备量和覆盖面,它有3000万以上正规授权代理IP、覆盖300多个城市,需要指定地区的出口时在提取参数里直接选。接口兼容requests、Scrapy这些主流库,接入成本很低。
新手最容易踩的四个坑
代码能跑只是及格线,下面这几个坑才是拉开差距的地方:
| 常见的坑 | 典型表现 | 解决办法 |
|---|---|---|
| 忘写 timeout | 程序卡在某个请求上不动 | 所有请求统一加 timeout=10 |
| 只取不补 | 跑半小时后池子见底 | 每轮检查存量,低于阈值自动提取 |
| 坏IP反复用 | 成功率越跑越低 | 失败就扣分,分数归零直接踢出 |
| 请求太猛 | IP成片失效 | 每次请求之间 sleep 1~2 秒 |
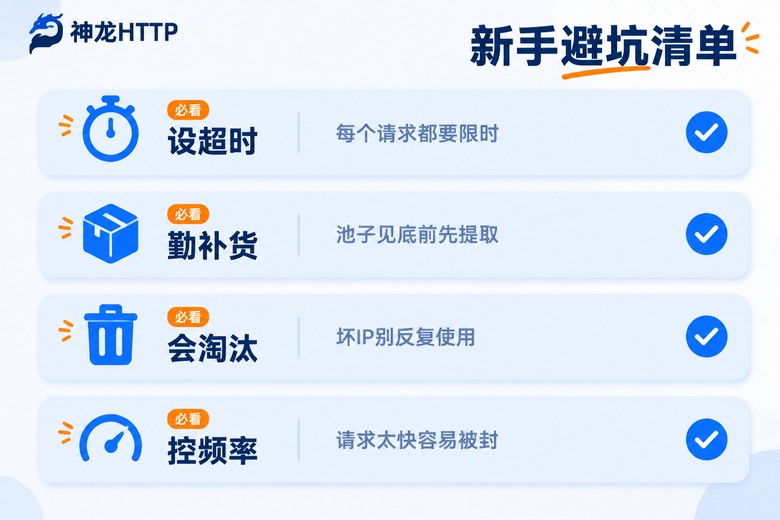
单独说说"请求太猛"这条。不少人以为池子越大越猛,请求开到几十并发,结果IP死得比补得还快。频率和池子大小要匹配,宁可慢一点——稳稳跑完,比中途崩掉重来省时间得多。
常见问题
Q:免费的IP列表能不能直接喂给这个池子?
能跑,但只建议拿来练手。免费IP存活时间短、可用率不稳定,经常是你刚测通、正式任务一跑就失效。正经采集项目建议对接付费提取接口,神龙HTTP这类服务可用率能做到99.9%,省下的调试时间远比服务费值钱。
Q:短效动态IP和长效静态IP怎么选?
看任务时长。短效动态IP每隔几分钟到几十分钟就是新的一批,适合量大、单次请求很快完成的采集;如果需要登录后保持会话、连续操作几十分钟不断线,就选长效静态IP。神龙HTTP两条产品线都有,按任务特点取用。
Q:我用的是Scrapy,这套代码还能用吗?
思路完全通用,接法不同。Scrapy里不建议每个请求手写proxies,标准做法是写一个下载中间件:process_request里从池子取IP塞进request.meta,请求异常时调mark_failed扣分。SimpleIPPool这个类原样搬过去就能配合使用。
Q:池子维持多大才够用?
取决于采集频率和IP存活时间。粗略估算:单个IP每分钟能安全请求10次,你的任务每分钟要发200个请求,那池子保持20个以上可用IP就比较稳。神龙HTTP个人中心有可视化的用量统计和实时监控,跑几天看看消耗曲线再调整补货阈值,比拍脑袋定数字靠谱。