做数据采集的人大概都经历过这种崩溃:脚本跑了整整一夜,早上打开日志一看,成功率低得可怜,翻两行就是 connection timeout。代码没动过,昨天还好好的——问题多半出在代理上。手里的IP早就失效了,程序还在一个劲地往死IP上发请求,时间全耗在无效等待里。
所以拿到代理IP之后,别急着跑业务,先花几行代码把可用性验一遍。这件事看着不起眼,却直接决定采集任务的成败率。下面把整套验证思路和可运行的代码一次讲清楚。
能连上不等于能用,先分清三个层次
很多人验证代理就是 ping 一下,通了就当没问题。这是最常见的误区。ping 走的是 ICMP 协议,代理服务走的是 HTTP 或 SOCKS5 端口,完全是两码事。端口没开、服务没启动、鉴权没配对,ping 得再欢,实际请求照样失败。
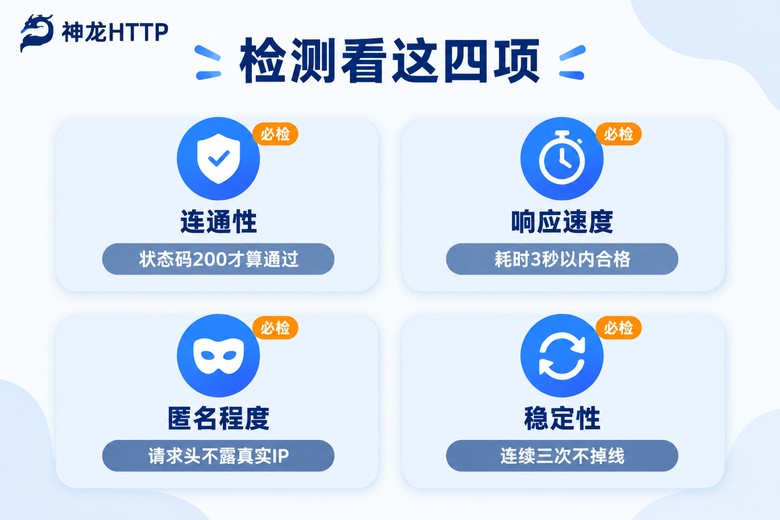
真正靠谱的验证要过三关:连得上,TCP 层面能建立连接,不超时、不被拒绝;走得通,带上代理发请求,能拿到 200 状态码;真生效,返回内容里看到的出口IP是代理的,不是你本机的,而且请求头里没把真实IP泄露出去。四个维度整理成一张表,验证时逐项对着看:
| 检测项 | 判断依据 | 不合格的典型表现 |
|---|---|---|
| 连通性 | 状态码返回 200 | 连接超时、拒绝连接 |
| 响应速度 | 耗时 3 秒以内 | 5 秒开外,拖慢整个任务 |
| 匿名度 | 请求头无 Via、X-Forwarded-For | 目标网站能看到真实IP |
| 稳定性 | 连续 3 次请求都成功 | 时通时断,用着用着就挂 |
最简版验证:requests 加个超时就能跑
先上最精简的版本,核心就一个函数:
import requests

def check_proxy(ip, port, timeout=5):
    """验证代理是否可用,返回 (是否可用, 出口IP)"""
    proxies = {
        "http": f"http://{ip}:{port}",
        "https": f"http://{ip}:{port}",
    }
    try:
        resp = requests.get(
            "https://httpbin.org/ip",  # 任意能回显出口IP的接口都行
            proxies=proxies,
            timeout=timeout,
        )
        if resp.status_code == 200:
            return True, resp.json().get("origin", "")
    except requests.exceptions.RequestException:
        pass
    return False, None

ok, exit_ip = check_proxy("117.50.xx.xx", 8080)
print(f"可用: {ok}, 出口IP: {exit_ip}")三个要点值得说一下。timeout 必须设,死代理最坑的地方不是连不上,而是让程序干等,不设超时一个坏IP就能卡住整个任务;except 里接 RequestException,超时、拒绝连接、代理错误全都兜住,一个坏IP不能影响后面的流程;用代理去请求一个会回显出口IP的接口,返回的 origin 和你本机公网IP对不上,才说明代理真的生效了——这一步同时覆盖了"连得上"和"走得通"。
通了只是及格线,耗时和匿名度得一起测
能用和好用之间差着两个指标:响应耗时和匿名程度。耗时长的代理会让并发任务整体变慢,别人 10 分钟能跑完的量,你要等半小时;匿名度不够的透明代理,目标网站直接看到你的真实IP,等于白挂。
升级版代码,把耗时和请求头一起检查:
import time
import requests

def check_detail(ip, port, timeout=5):
    """返回耗时与匿名度信息,不可用时返回 None"""
    proxies = {
        "http": f"http://{ip}:{port}",
        "https": f"http://{ip}:{port}",
    }
    start = time.time()
    try:
        resp = requests.get(
            "https://httpbin.org/get",
            proxies=proxies,
            timeout=timeout,
        )
        cost_ms = int((time.time() - start) * 1000)
        if resp.status_code != 200:
            return None
        data = resp.json()
        headers = data.get("headers", {})
        # 请求头里带这些字段,说明匿名度不够
        anonymous = not any(
            k in headers for k in ("Via", "X-Forwarded-For", "Proxy-Connection")
        )
        return {"cost_ms": cost_ms, "anonymous": anonymous}
    except requests.exceptions.RequestException:
return None拿到返回值后这样判断:cost_ms 在 1000 以内算优质,1000 到 3000 算可用,超过 3000 建议直接放弃;anonymous 为 False,说明请求头里带了 Via 或 X-Forwarded-For,属于透明代理,对匿名有要求的场景别用。
IP 一多就并发测,测完按分数分级
手上有几十上百个IP时,串行一个一个测太慢,测完一轮黄花菜都凉了。上线程池,20 个并发几分钟搞定:
from concurrent.futures import ThreadPoolExecutor, as_completed

def grade(ip, port):
    """打分:2=优质 1=可用 0=淘汰"""
    info = check_detail(ip, port)
    if info is None:
        return 0
    if info["cost_ms"] <= 1000 and info["anonymous"]:
        return 2
    if info["cost_ms"] <= 3000:
        return 1
    return 0

def check_all(proxy_list, workers=20):
    """proxy_list 形如 [{"ip": "x.x.x.x", "port": 8080}, ...]"""
    result = {}
    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {
            pool.submit(grade, p["ip"], p["port"]): p for p in proxy_list
        }
        for fut in as_completed(futures):
            p = futures[fut]
            result[f"{p['ip']}:{p['port']}"] = fut.result()
    return result
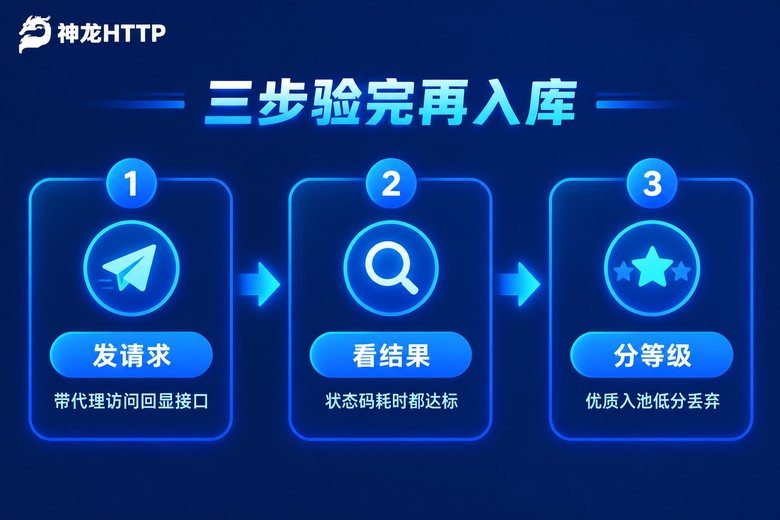
测完的结果建议按分数分池管理:2 分进核心池,业务请求优先从这里取;1 分进备用池,核心池不够时顶上;0 分直接丢弃,别心疼。另外并发数别贪大,20 左右比较稳,开太高反而会把服务商的提取接口打到限流,得不偿失。
把验证嵌进使用流程,而不是测一次就完事
IP 是消耗品,尤其是短效动态代理,生命周期可能就几分钟,验证完扔进池子里不管,照样会失效。比较实用的做法是把验证拆成三层:
1. 入库前全量验证,按上面的完整流程测,耗时、匿名度都过关才入库;2. 取用时轻量验证——每次从池里拿IP,顺手发一个 1 秒超时的快速请求,只测连通,失败就跳过取下一个;3. 失败后自动淘汰——同一个IP业务请求连续失败 2 到 3 次,标记剔除,下次不再分配。
这套逻辑不复杂,但能把无效请求压到很低。如果你用的是神龙HTTP这类正规服务商,本身可用率就有 99.9% 的保障,等于在本地验证之外多了一道保险。它的提取接口兼容主流爬虫语言的 API 调用,把提取到的IP直接喂给上面的 check_all 函数,整条"提取—验证—入池—使用"的链路就跑通了。协议上同时支持 HTTP、HTTPS、SOCKS5,验证代码里把 proxies 的协议头对应换掉即可;个人中心里的可视化用量统计和实时监控,还能帮你盯着哪些IP出了异常。
常见问题
Q: 检测接口会不会被限流?
httpbin 这类公共接口有频率限制,量大了可能返回 429。两个办法:轮换几个不同的检测地址分摊压力,或者自己起一个最简单的回显服务,几十行 Flask 代码就能搞定,检测流量全走自己的,想测多快测多快。
Q: 超时时间设多少合适?
验证环节建议 5 秒封顶,对速度敏感的业务收到 2 到 3 秒。原则是宁可错杀——验证阶段就超时的IP,实际用起来大概率也不行,留着只是占地方。
Q: 为什么有的IP能 ping 通,代理请求却失败?
ping 走 ICMP 协议,代理走 HTTP/SOCKS5 端口,协议不同。端口没开放、服务没启动、需要鉴权没填,都会出现"ping 得通、用不了"的情况。所以验证必须用真实请求,ping 只能当参考,不能当结论。
Q: 短效动态IP和长效静态IP,验证策略一样吗?
不一样。短效IP生命周期短,验证要快、淘汰要狠,验证不过立刻获取新的IP顶上;长效静态IP可以测得细一些,通过后长期复用,每隔几小时复验一次即可,重点看稳定性而不是单次速度。