一、IP的纯净度与可用率是命根子
很多人在跑数据采集任务时,经常遇到代码写得好好的,但一跑起来全是报错,不是超时就是连接被拒绝。这往往不是你代码的问题,而是你用的代理IP太“脏”了。有些劣质代理IP被无数人用过,早被目标网站拉黑了。

挑代理IP第一点就得看纯净度和可用率。拿神龙HTTP来说,他们的IP资源都是国内三大运营商正规授权的,每个IP在分配给你之前都经过了严格的筛选和验证,IP纯度能达到99.8%,可用率高达99.9%。这意味着什么?意味着你跑程序的时候,不用频繁去处理那些因为IP失效导致的断线问题,工作效率能提升一大截。
二、IP池的规模与地域覆盖决定你的天花板
做公开数据采集,如果IP池太小,或者节点都在同一个地方,很容易被目标网站识别出来。咱们需要的是一个大且分布广泛的IP资源库。
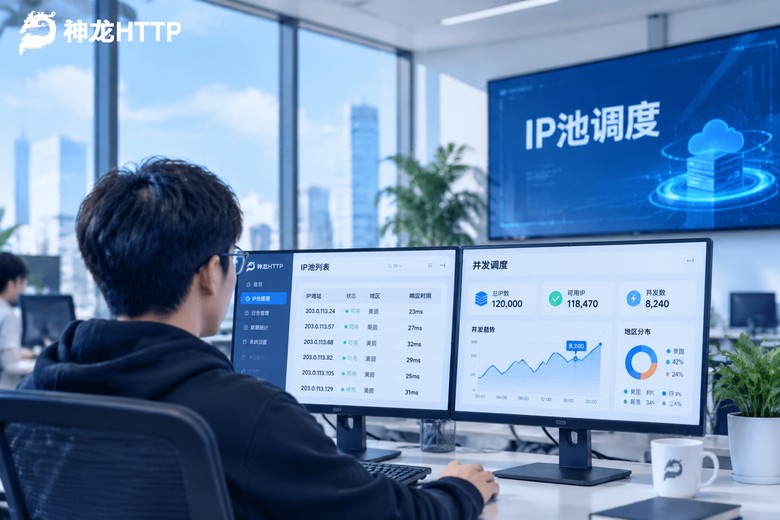
神龙HTTP在这方面底气很足,他们拥有超3000万+的代理资源储备,而且每天都在更新去重。更关键的是,他们支持300+城市级精准定位。不管你是需要热门城市的节点,还是需要一些稀有地区的节点,都能精准获取。这对于需要做区域性市场研究或者特定城市数据抓取的朋友来说,非常实用。
| 对比项 | 劣质代理IP | 神龙HTTP代理IP |
|---|---|---|
| IP池规模 | 几万到几十万,重复率高 | 3000万+资源,每日更新去重 |
| 地域覆盖 | 节点混杂,无法指定地区 | 300+城市级精准定位 |
| 纯净度 | 共用严重,易被封禁 | 正规授权,纯度99.8% |
三、技术支持与集成便捷度影响你的开发效率
买代理不是买完就完事了,得能快速用起来。如果API接口写得乱七八糟,文档也看不懂,那对接起来能把你折腾死。
神龙HTTP的API接口兼容各种主流爬虫编程语言,能帮你实现快速集成。他们提供详尽的文档和示例代码,就算你是刚入行的新手,照着文档也能很快跑通。而且,他们的个人中心有可视化数据统计,你能直观地掌握IP使用情况和使用趋势。如果遇到什么问题,技术团队提供724小时的支持服务,随时能找到人解答。
这里给大家看个简单的Python调用示例,其实对接起来就这么简单:
import requests

 神龙HTTP代理服务器地址和端口
proxy_host = "your_proxy_host"
proxy_port = "your_proxy_port"
proxy_user = "your_username"
proxy_pass = "your_password"

proxy_url = f"http://{proxy_user}:{proxy_pass}@{proxy_host}:{proxy_port}"

proxies = {
    "http": proxy_url,
    "https": proxy_url,
}

 目标网址
target_url = "http://httpbin.org/ip"

try:
    response = requests.get(target_url, proxies=proxies, timeout=10)
    print(f"请求成功,返回IP信息:{response.text}")
except Exception as e:
    print(f"请求失败:{e}")
神龙HTTP套餐怎么选才合适?
神龙HTTP提供了好几种套餐,大家不用眼花缭乱,根据自己的业务需求对号入座就行。这里简单介绍两个常用的:
1. 短效动态IP池:这个套餐以短效动态IP为主(3/5/10/15/30分钟,还能定制)。如果你是做高频的公开数据采集,需要不断更换IP地址,选这个准没错。它的连通率高,并发量大,计费方式也很灵活,包量或者包时都可以。
2. 固定IP池:这个是基于高性能云主机构建的,IP存活时间长,稳定性很高。如果你对IP需求量不大,但是要求连接必须稳,比如一些需要长时间保持会话的数据传输任务,按个数买这个套餐最合适。
常见问题QA
Q1:我是做AI大模型训练的,需要处理复杂网络环境下的数据抓取,神龙HTTP能扛得住吗?
A:完全没问题。神龙HTTP不仅持续扩充IP代理池,还具备处理复杂网络环境的能力。不管是高并发还是大规模采集需求,他们都能提供稳定可靠的代理服务,你的AI大模型训练高效运行。
Q2:如果我的业务比较特殊,常规套餐满足不了怎么办?
A:神龙HTTP有专门的“企业定制池”服务。他们的大客户经理会一对一深度剖析你的业务特点和日常用量,为你量身定制专属的数据采集方案,技术团队也是724小时在线支持,不用担心业务跑不起来。