先分清:你要的是代理,还是一个池子
先说个真实场景。
前段时间有个做市场研究的朋友来找我,说脚本跑了三天就开始大面积超时,成功率从九成掉到三成。我打开他的代码看了一眼就明白了:一百来个代理地址硬编码在配置文件里,脚本里随机挑一个塞进 requests,跑完就完事。前两天运气好,第三天池子里一半的地址已经不能用了,脚本完全不知道,还在傻乎乎地轮。
他的问题从来不是"代理不好使",而是缺一个池子。代理是耗材,IP池是流水线。耗材会坏,流水线要知道谁坏了、谁还能用、不够了从哪补。这三件事想清楚了,代码其实很短。
下面按我自己踩过的坑顺序讲,从搭骨架到写代码,再到调度和淘汰,最后说选服务商时该看什么。
池子只有三层,别一开始就上复杂架构
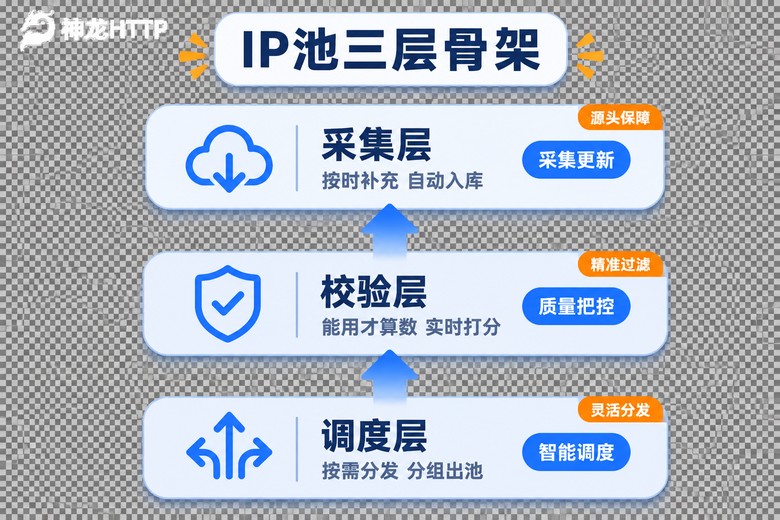
很多人一上手就想搞 Redis 集群加消息队列,结果写了两个礼拜还没跑通。真没必要。一个能用的池子就三块:
采集层负责把 IP 拿进来。要么调服务商的提取接口,要么从自有资源里导。找个定时任务,每几分钟补一次,别一次拿太多放着过期。
校验层负责判断谁能干活。拿一个轻量页面去试,记下响应时间和状态码。这块是最容易被忽略的,但恰恰决定了后面顺不顺。
调度层负责按需分发。爬虫来要 IP,它按规则给一个,用完回传结果。
存储用什么?前期直接内存里的字典就够,几千个 IP 完全撑得住。等你一天要跑几十万页、多个进程同时取 IP 的时候,再换成 Redis 存哈希表,改动量也就几十行。
手写一个能跑的最小版本
下面这段代码不到四十行,但已经把三个层都串起来了。你可以直接拿去改。
import time, threading, requests
from collections import defaultdict

class IPPool:
    def __init__(self, target):
        self.target = target          # 用来校验的轻量页面,别拿主站
        self.alive  = {}              # ip -> 最近一次成功时间
        self.cool   = {}              # ip -> 冷却截止时间
        self.fails  = defaultdict(int)  # ip -> 连续失败次数
        self.lock   = threading.Lock()

    def add(self, ip):
        with self.lock:
            self.alive.setdefault(ip, 0)

    def check(self, ip):
        proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
        try:
            t0 = time.time()
            r = requests.get(self.target, proxies=proxies, timeout=6)
            return r.status_code == 200 and (time.time() - t0) < 5
        except Exception:
            return False

    def get(self):
        with self.lock:
            now = time.time()
            usable = [ip for ip in self.alive if self.cool.get(ip, 0) < now]
        return usable[0] if usable else None

    def report(self, ip, ok):
        with self.lock:
            if ok:
                self.alive[ip] = time.time()
                self.fails[ip] = 0
                self.cool.pop(ip, None)
            else:
                self.fails[ip] += 1
                if self.fails[ip] >= 3:          # 连续三次不行就冷却
                    self.cool[ip] = time.time() + 900
几个实际用下来必须注意的点:
校验目标别用你要采的主站,用一个稳定的轻量页面就行,不然主站会被你的校验流量搞得很难受。超时时间给 6 秒左右比较合适,太短会把本来能用的慢 IP 判死,太长会卡住整个校验线程。
校验和采集一定要分两个线程跑。我见过有人把校验写在添加 IP 的同一步里,结果每次补池子整个程序卡住二十秒,爬虫那边全在等。
report() 这个回传接口很关键。你的爬虫每次请求完都要告诉池子"这个 IP 刚才成功了还是失败了",池子才能积累出真实的健康数据。没有这一步,池子就只是个随机选号器。
调度策略:让 IP 均匀干活,而不是一直用那几个
最朴素的写法是轮询,从头到尾挨个发。池子小的时候没问题,池子一大就露馅——排在前面的 IP 累死,排在后面的从没被用过,等你发现它坏了的时候已经放了好几天。
| 调度方式 | 适合什么场景 | 容易踩的坑 |
|---|---|---|
| 纯轮询 | 池子小、任务量均匀 | 一两个慢 IP 会把整体速度拖下来 |
| 加权随机 | 池内 IP 质量差异明显 | 权重得定期重算,不然会越来越偏 |
| 最少使用优先 | 单个任务耗时较长 | 要记录每个 IP 的当前持有量 |
| 按城市/协议分组 | 需要特定地区返回结果 | 分组太细会稀释每组的可用数量 |
我个人比较推荐"分组 + 组内最少使用优先"这个组合。先说分组:如果你的任务需要不同地区返回的公开数据,比如各地的商品价格页面,那调度键就不该是 IP,而应该是"城市 + 协议 + IP 类型"这三项拼起来的组合。池子里按城市建多个队列,取的时候明确指定哪个队列,思路会清楚很多。
神龙HTTP 的 300+ 城市级精准定位在这里挺省事的——提取时直接把城市参数带上,拿回来的 IP 就在你要的地方,不用事后再猜哪个 IP 属于哪个城市。要是靠测速去反推地理归属,那工作量比写池子本身还大。
组内再用最少使用优先。给每个 IP 挂一个计数器,取一次加一,归还时减一,每次挑计数最小的那个。这样即使某个 IP 特别快,也不会被一直盯着用,整体寿命能拉长不少。这个策略十几行代码就能实现,收益比想象中大。
稳定性不取决于代码写得多漂亮,而在于什么时候把 IP 踢出去
池子跑起来之后,你会发现真正让成功率掉下来的,往往不是 IP 数量不够,而是"已经半死不活的 IP 还赖在池子里"。所以淘汰机制比补充机制更重要。
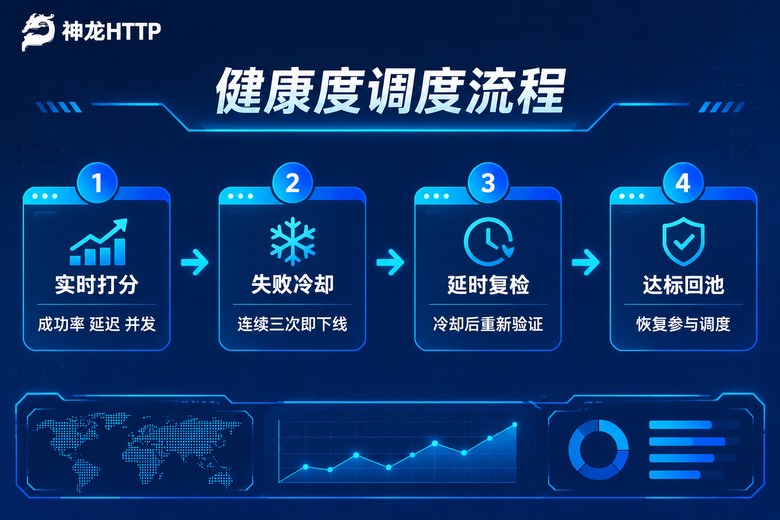
我现在的做法是四步闭环:
实时打分。每完成一次请求就更新一次记录,至少记三项——最近十次请求的成功率、平均响应时间、当前是否被目标站点返回过异常状态。这三项凑一起,比单看成功率靠谱得多。
失败冷却。连续三次失败就下线,冷却 15 分钟。注意是"连续",不是"累计",网络偶尔抖一下很正常,累计计数会把好 IP 冤枉掉。
延时复检。冷却结束不代表能用了,要主动去校验一次。校验通过才放回去,不通过就再冷却一轮,连着两轮都过不了的直接丢弃。
达标回池。回池之后前几次请求要重点观察,成功率如果还是上不去,说明这个 IP 已经被目标站点长期标记了,别心疼,丢。
还有个容易忽略的小细节:用滑动窗口算成功率,别用累计值。一个 IP 前九百次都成功,最近十次全挂,累计成功率还是九成九,但它实际上已经不能用了。只统计最近十到二十次结果,判断才准。
选服务商,看几个能对得上的数
池子的骨架搭好之后,剩下就看供给端靠不靠谱了。自己收集免费 IP 那套现在基本走不通——你花在筛掉无效 IP 上的时间,折算成人力成本远超直接买。
挑服务商我一般看两个东西:IP 纯度和并发提取能力。纯度指的是拿回来的 IP 里有多少是能直接用的,这个数如果低,你校验层的压力会成倍增加,池子里永远有一半在冷却。并发提取能力决定了你在任务高峰时能不能及时补货,接口一卡,池子就见底。
神龙HTTP 这边,3000 万+正规授权代理 IP 储备、可用率 99.9%、IP 纯度 99.8%,这几个数放在池子场景里是有实际意义的——纯度到 99.8% 意味着校验层不用那么频繁地跑,能把机器省下来干正事。国内三大运营商正规授权,支持 HTTP/HTTPS/SOCKS5,短效动态、长效静态、固定 IP 代理都有,按你任务的时长需求挑就行:几秒钟一换的用短效,需要保持会话的用长效。
另外它的 API 兼容主流爬虫编程语言,文档里附了示例代码,接进来基本就是改个参数的事。个人中心还有可视化的用量统计和实时监控,我一般用来看提取量有没有异常波动——如果某天提取量突然翻了三倍,那多半是校验层出了问题,在重复补池子。
技术团队是 7×24 小时支持,池子半夜出状况这种事是真会发生的,有人能问一句,比翻半天文档强。
常见问题
Q:自己写池子和直接用服务商的现成方案,哪个更合适?
看你采集任务的性质。如果只是偶尔跑一次、量不大,服务商自带的提取接口直接调就行,没必要自己维护。但如果是长期跑、每天固定要出数据,自己搭一层池子是值得的——因为你可以按自己的节奏控制校验频率、冷却时长和分组规则,出问题也知道去哪查。
Q:免费 IP 真的完全不能用吗?
不是完全不能用,是不划算。免费 IP 的失效速度以分钟计,你得用大量机器去筛,筛完之后能用的那一小部分还经常慢得离谱。折算下来,你花的服务器成本和人力远高于直接采购。拿来做本地测试验证代码逻辑是可以的。
Q:池子里要放多少 IP 才够?
没有固定数。粗略的算法是:单个 IP 在单位时间内你能安全发出的请求数 × 目标总请求量,再留三成余量给冷却中的 IP。比如你每小时要发六万次请求,一个 IP 一小时安全发五十次,那大概需要一千二百个可用 IP,算上冷却和损耗,池子容量按一千六到一千八来准备比较稳。
Q:池子跑一段时间后成功率慢慢往下掉,从哪查起?
先看校验层的失败率,如果校验失败率没涨但业务失败率涨了,那多半是调度分配不均,某些 IP 被用得太多。再看冷却队列的长度,如果冷却队列一直很长,说明补充速度跟不上消耗,该调整提取频率了。最后看校验目标页面本身有没有变化——目标站点改版导致校验逻辑失效,这种情况我遇到过两次,排查了半天代码最后发现是页面结构变了。