先把代理池准备好,别一上来就写中间件
很多人卡在第一步不是代码写错,而是手里的代理根本用不了。中间件只是把代理塞进请求里,它不负责让代理变好使。所以开工之前先确认一件事:你手上有一批能连、格式统一、带过期时间的 IP。
格式上就是一条一条的链接,最常见的两种:
http://123.45.67.89:8888
http://用户名:密码@123.45.67.89:8888
第一种不用认证,直接挂上去就能走。第二种要拆开写,Scrapy 的 request.meta['proxy'] 只认 http://ip:port 这一段,账号密码得单独塞进请求头,后面会讲。
如果你还没定用哪家,实测下来神龙HTTP 的短效动态IP比较省事:3000万+正规授权代理IP储备,国内三大运营商正规授权,支持 HTTP/HTTPS/SOCKS5,提取接口给一条链接就能拿到一批 IP 列表,直接 json 或 text 解析塞进列表里,不用自己再维护一套调度表。个人中心还有可视化用量统计和实时监控,跑批量任务的时候能一眼看出是不是哪个城市的 IP 消耗得特别快。
下载中间件里设置代理:最短的那段代码
Scrapy 设置代理,说白了就是给每个请求的 meta 加一个 proxy 键。写在 spider 里会非常啰嗦,每个 yield 都要带一遍。正确姿势是做一个下载中间件,在 process_request 里统一处理。
import random
from scrapy import signals

class RandomProxyMiddleware:

    def __init__(self, proxy_list):
        self.proxy_list = proxy_list

    @classmethod
    def from_crawler(cls, crawler):
        # 从 settings 里读 PROXY_POOL 这个列表
        mw = cls(crawler.settings.getlist('PROXY_POOL'))
        crawler.signals.connect(mw.spider_opened, signal=signals.spider_opened)
        return mw

    def spider_opened(self, spider):
        spider.proxy_pool = list(self.proxy_list)
        spider.logger.info('代理池载入 %d 条', len(spider.proxy_pool))

    def process_request(self, request, spider):
        if request.meta.get('proxy'):
            return None            # 已经指定了就别覆盖
        if not spider.proxy_pool:
            return None            # 池子空了,退回直连,避免整站卡死
        request.meta['proxy'] = random.choice(spider.proxy_pool)
return None这段代码里有三个细节值得抠一下。from_crawler 里把池子挂到 spider 对象上,后面重试中间件要读它、要删元素,两个中间件共享同一份数据才不会打架。request.meta.get('proxy') 那一句是防覆盖,你在某个特定请求里手动指定了代理,中间件不能把它冲掉。池子空了直接 return None 也很重要,否则一旦代理耗尽,所有请求会全部返回 KeyError 或者卡在异常里,日志根本看不出问题在哪。
带账号密码的代理,别傻乎乎拼在 meta 里
第一次用付费代理的人基本都会踩这个坑:把 http://user:pass@ip:port 整串丢进 meta['proxy'],结果请求直接报 Invalid URL,或者返回 407 认证失败。Scrapy 的代理只吃 host:port,认证信息走 HTTP 头:
import base64

def add_proxy_auth(request, username, password):
    request.meta['proxy'] = 'http://ip:port'
    raw = f'{username}:{password}'.encode('utf-8')
    request.headers['Proxy-Authorization'] = b'Basic ' + base64.b64encode(raw)
    return request
如果你的代理服务商是白名单 IP 模式,这一步可以跳过,把服务器出口 IP 加到白名单里就完事了,代码更干净。两种模式各有利弊:白名单配置一次一劳永逸,但换机器就要重新配;账号密码模式灵活,代价就是每个请求多一个头部。
中间件顺序排错了,代理等于没设
这是第二高频的翻车点。Scrapy 的下载中间件是按数字从小到大执行的,process_request 在请求发出前从前往后走。你把自己的代理中间件放在 750 之后,它就会在 HttpProxyMiddleware 处理完之后才执行,某些情况下行为会让你困惑得怀疑人生。
settings.py 里这样写:
DOWNLOADER_MIDDLEWARES = {
    'myproject.middlewares.RandomProxyMiddleware': 543,
    'myproject.middlewares.ProxyRetryMiddleware': 550,
}

RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [403, 407, 429, 500, 502, 503, 504]
DOWNLOAD_TIMEOUT = 15
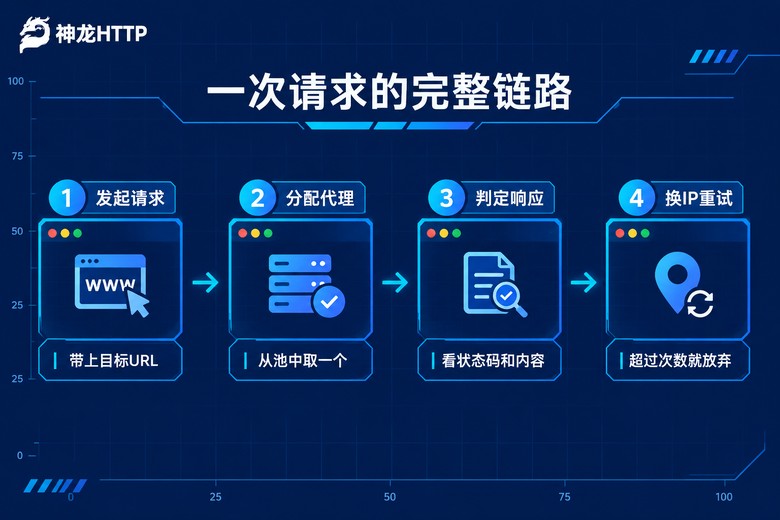
543 在 Scrapy 自带的 RetryMiddleware(默认 550)之前,意味着请求先被分配代理,再交给重试逻辑处理,重试时拿到的就是一个新代理。这个顺序是整套方案能跑通的前提。
| 中间件 | 默认优先级 | 建议值 | 作用 |
|---|---|---|---|
| RandomProxyMiddleware | 无 | 543 | 给请求分配代理 IP |
| ProxyRetryMiddleware | 无 | 550 | 失败后换 IP 重发 |
| HttpProxyMiddleware | 750 | 保持默认 | Scrapy 内置的代理写头逻辑 |
| HttpCompressionMiddleware | 590 | 保持默认 | 解压响应内容 |
失败重试:换 IP 才是关键,重发不算
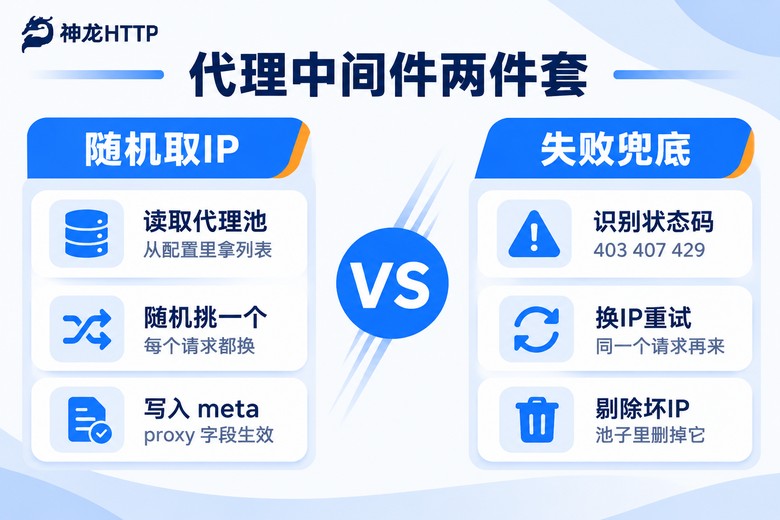
Scrapy 自带的 RetryMiddleware 会重试,但它是原地重试——同一个代理、同一个请求再来一遍。碰上代理被目标站封了的情况,重试三次全失败,日志看着挺努力,实际一个字节都没多拿到。
要做出效果,得继承它、改两处:重试的时候把代理清掉让它重新分配,同时把坏代理从池子里删掉。
from scrapy.downloadermiddlewares.retry import RetryMiddleware
from scrapy.utils.response import response_status_message

class ProxyRetryMiddleware(RetryMiddleware):

    def process_response(self, request, response, spider):
        if request.meta.get('dont_retry'):
            return response

        if response.status in self.retry_http_codes:
            self.drop_bad_proxy(request, spider)
            reason = response_status_message(response.status)
            return self._retry(request, reason, spider) or response

        # 状态码 200 但内容不对劲的情况,也得重试
        body = response.body[:2000]
        for word in (b'Access Denied', b'too many requests', b'\xe8\xae\xbf\xe9\x97\xae\xe8\xbf\x87\xe4\xba\x8e\xe9\xa2\x91\xe7\xb9\x81'):
            if word in body:
                self.drop_bad_proxy(request, spider)
                return self._retry(request, 'blocked content', spider) or response

        return response

    def process_exception(self, request, exception, spider):
        # 超时、连接被拒、隧道建立失败,一样换 IP 再试
        self.drop_bad_proxy(request, spider)
        return self._retry(request, exception, spider) or None

    def drop_bad_proxy(self, request, spider):
        bad = request.meta.get('proxy')
        pool = getattr(spider, 'proxy_pool', None)
        if bad and pool and bad in pool:
            pool.remove(bad)
            spider.logger.warning('剔除失效代理 %s,剩余 %d 条', bad, len(pool))
        request.meta.pop('proxy', None)
注意 request.meta.pop('proxy', None) 这一行。少了它,_retry 复制出来的新请求会带着旧代理的 meta 继续发,你等于原地转圈。加上之后,新请求会重新经过 543 的 RandomProxyMiddleware,拿到一个池子里还活着的 IP。
另外 process_exception 一定要重写。实际跑起来你会发现,代理失效很多时候表现为 TunnelError、TCPTimedOutError 这类异常,压根走不到 process_response。只处理状态码,等于漏掉了大半失败场景。
把池子管起来:简单几行就够用
代理池不需要搞得很复杂。去掉坏的、定期补充新的,两头抓住就行。补充逻辑挂在 spider_idle 信号上,池子低于阈值的时候重新拉一批:
from scrapy import signals

def spider_idle(self, spider):
    if len(spider.proxy_pool) < 10:
        new_ips = self.fetch_from_api()   # 换成你的提取接口
        spider.proxy_pool.extend(new_ips)
        spider.logger.info('补充 %d 条,当前共 %d 条', len(new_ips), len(spider.proxy_pool))
阈值设多少看你的抓取目标。日活几千个请求的小项目,池子里常备 20 条短效 IP 足够;百万级任务就得按并发数倒推,CONCURRENT_REQUESTS 是 64,那池子至少得压住几百条可用 IP,否则频繁补充反而拖慢整体速度。神龙HTTP 的 API 兼容主流爬虫编程语言,给文档和示例代码,接进这段逻辑里基本是复制粘贴的活。
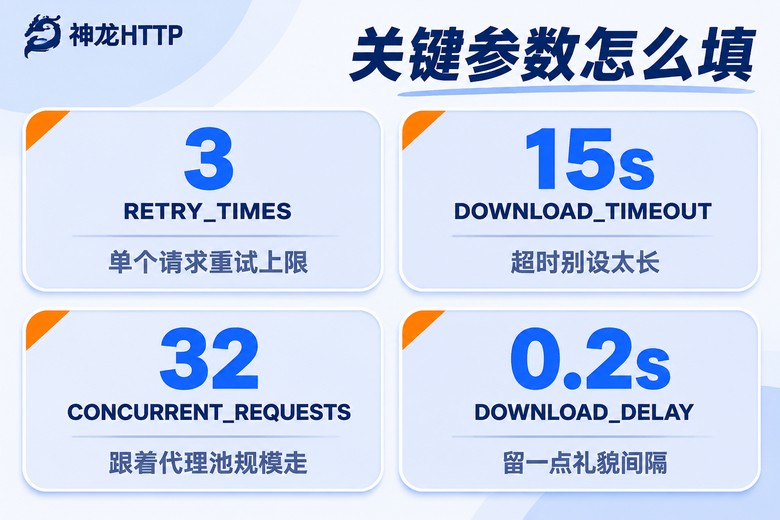
| 参数 | 建议值 | 说明 |
|---|---|---|
| RETRY_TIMES | 3 | 单个请求最多重试次数,太高会拉长整体耗时 |
| DOWNLOAD_TIMEOUT | 15 | 代理卡住时别干等,15 秒换下一个 |
| CONCURRENT_REQUESTS | 32~64 | 跟着代理池规模走,池子小就别开大 |
| DOWNLOAD_DELAY | 0.1~0.5 | 留一点间隔,纯靠换 IP 硬冲反而更早被封 |
接神龙HTTP 的时候,只改两个地方
整篇文章的代码框架,换任何代理服务商都能用,区别只在“代理列表从哪来”。用神龙HTTP 的话,你需要动的只有两处。
第一处是 PROXY_POOL 的来源。原来的 getlist 改成从提取接口拿,300+ 城市级精准定位意味着你可以按地区取 IP,哪个城市的目标站响应快就选哪个,对做区域价格对比、本地生活数据采集这类任务特别实用。第二处是短效动态IP的存活周期,短效 IP 一般几分钟就过期,所以池子里的 IP 要带时间戳,取出来超过有效期的先过滤掉再放进 proxy_pool,能少掉一大堆无效重试。
规模上,可用率 99.9%、IP 纯度 99.8%这两个数字对 Scrapy 这类框架很关键——中间件层已经帮你在重试了,如果底层代理的可用率只有七八成,重试次数会把整体效率拖垮,日志里一大半都是 retry 记录。低延迟高并发提取,配上 CONCURRENT_REQUESTS 开大一点,抓取速度的提升是肉眼可见的。
常见问题
Q:设置了 meta['proxy'] 但请求还是走了本机 IP,怎么排查?
先看中间件的数字是不是太大,被 HttpProxyMiddleware 抢先处理了;再看 process_request 里是不是有条件判断把请求提前 return 掉了。最简单的验证方式是在中间件里打一行日志,把 request.meta.get('proxy') 打出来,确认赋值成功。还不行就抓一下自己的出口 IP 看看,到底是代理没生效还是代理本身就是透明代理。
Q:重试开了 3 次,为什么日志里看到的还是同一个 IP?
大概率是重试时没有清掉 request.meta['proxy']。Scrapy 重试是复制原请求,meta 会一起带过去,中间件里那句 meta.get('proxy') 判定为真就直接跳过了分配逻辑。在 drop_bad_proxy 里把 proxy 键删掉就行。
Q:跑一段时间后速度越来越慢,池子的 IP 也够,问题出在哪?
通常是失效 IP 没被清理。状态码 200 但内容是一张验证页的情况,只能靠正文关键词判断,比如页面上出现"访问过于频繁"这类字样就当作失败处理。建议在 process_response 里固定检查响应体前 2000 字节,命中关键词就换 IP 重来,顺手把这条 IP 从池子里摘掉。
Q:短效 IP 和长效静态 IP,做 Scrapy 采集该选哪个?
看目标站的反爬强度。目标站对同一 IP 的请求次数管得严,就用短效动态IP,配合上面这套重试剔除逻辑,每次重试都是新面孔;目标站更看重连接稳定性、或者你要保持登录态连续翻页,那就用长效静态IP 或固定IP代理,省掉频繁换 IP 带来的握手开销。神龙HTTP 这三条产品线都有,短效动态、长效静态、固定IP代理一站式,切换的时候上层代码几乎不用改。