做 Python3 采集的人,经常会在代理这一步卡住:requests 怎么传 proxy,aiohttp 为什么不是 proxies,代理池里的 IP 怎么轮换,失败了要不要获取新的 IP。这篇文章按“能跑起来、能扩展、能监控”的顺序讲,尽量不绕术语。
先把代理池想清楚
代理池不是把一堆 IP 写死在代码里。更稳的方式是:把服务商的提取接口、账号信息、目标地区、数量等放到环境变量或配置中心,代码只负责“取 IP、建会话、失败重试”。神龙HTTP 提供 API 方式提取,支持 HTTP/HTTPS/SOCKS5,也提供文档和示例代码,适合 Python 项目快速接入。这里不展开具体套餐,只讲配置流程。
requests 接入:同步场景最直观
requests 的代理参数是 proxies,注意是复数。代理地址一般写成 http://用户名:密码@IP:端口。如果只测一个代理,可以先这样:
import os
import requests

PROVIDER_API = os.getenv("SHENLONG_HTTP_API_URL")
TARGET_URL = os.getenv("TARGET_URL")
PROXY = "http://user:pass@1.2.3.4:8080"  # 仅示意格式

proxies = {"http": PROXY, "https": PROXY}
resp = requests.get(TARGET_URL, proxies=proxies, timeout=10)
print(resp.status_code)
这里 http://user:pass@1.2.3.4:8080 是代理格式示例,不是真实账号。真实密钥建议从环境变量读取,不要写进代码仓库。目标地址也建议通过环境变量传入,方便不同环境复用同一套代码。
把代理池接进 requests:轮换和重试
实际项目里,一个 IP 用久了可能变慢、被限流,甚至临时不可用。比较常见的做法是:每次请求前从代理池获取新的 IP,请求失败就获取新的 IP 再试一次。下面是一个简化版池子:
import os
import random
import time
import requests

PROVIDER_API = os.getenv("SHENLONG_HTTP_API_URL")
PROVIDER_KEY = os.getenv("SHENLONG_HTTP_API_KEY", "")
TARGET_URL = os.getenv("TARGET_URL")

def get_proxy():
    resp = requests.get(
        PROVIDER_API,
        params={"key": PROVIDER_KEY, "count": 1},
        timeout=5,
    )
    resp.raise_for_status()
    item = resp.json()[0]
    return f"http://{item['username']}:{item['password']}@{item['ip']}:{item['port']}"

def fetch_with_retry(url, max_attempts=3):
    for attempt in range(1, max_attempts + 1):
        proxy = get_proxy()
        proxies = {"http": proxy, "https": proxy}
        try:
            resp = requests.get(url, proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp.text
        except requests.RequestException:
            if attempt == max_attempts:
                raise
            time.sleep(random.uniform(0.5, 1.5))
    return None
这个写法适合中小规模同步采集。重点不是“把 IP 存成列表”,而是每次失败都有恢复路径:重新提取、换个地区的 IP、缩短重试间隔,或者把失败 IP 标记出来。
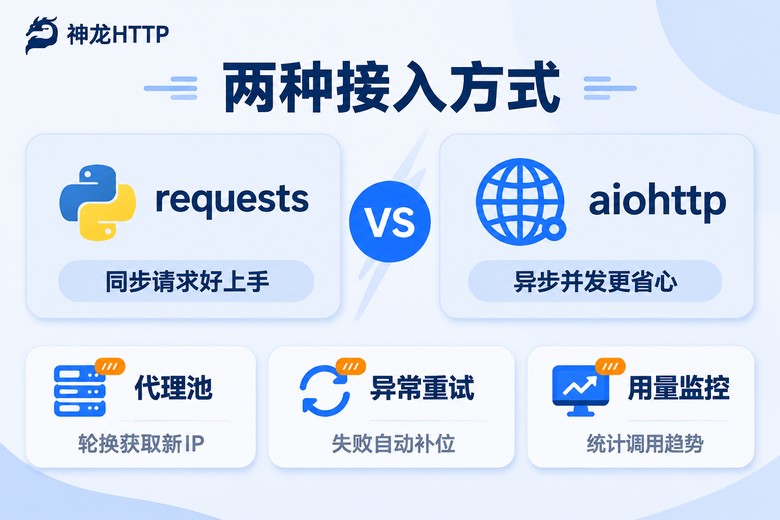
requests 和 aiohttp 的差别在哪里
| 对比点 | requests | aiohttp |
|---|---|---|
| 使用方式 | 同步调用,代码线性阅读 | 异步调用,适合高并发 |
| 代理参数 | proxies 字典 | proxy 单个参数 |
| 会话对象 | Session 可复用连接 | ClientSession 管理连接池 |
| 适合场景 | 脚本、调试、低并发 | 大规模并发采集、接口轮询 |
很多项目不是二选一。调试阶段用 requests 更快,线上跑量时再用 aiohttp 把并发提起来。
aiohttp 接入代理池:异步并发示例
aiohttp 的代理参数和 requests 不一样,通常直接传 proxy。如果你要做并发,建议用 ClientSession,避免每个请求都新建连接。
import os
import asyncio
import aiohttp

PROVIDER_API = os.getenv("SHENLONG_HTTP_API_URL")
PROVIDER_KEY = os.getenv("SHENLONG_HTTP_API_KEY", "")
TARGET_URL = os.getenv("TARGET_URL")

async def get_proxy(session):
    async with session.get(
        PROVIDER_API,
        params={"key": PROVIDER_KEY, "count": 1},
        timeout=aiohttp.ClientTimeout(total=5),
    ) as resp:
        resp.raise_for_status()
        data = await resp.json()
        item = data[0]
        return f"http://{item['username']}:{item['password']}@{item['ip']}:{item['port']}"

async def fetch_one(session, semaphore, max_attempts=3):
    async with semaphore:
        for attempt in range(1, max_attempts + 1):
            proxy = await get_proxy(session)
            try:
                async with session.get(
                    TARGET_URL,
                    proxy=proxy,
                    timeout=aiohttp.ClientTimeout(total=10),
                ) as resp:
                    if resp.status == 200:
                        return await resp.text()
            except aiohttp.ClientError:
                if attempt == max_attempts:
                    return None
                await asyncio.sleep(0.5)
        return None

async def main():
    semaphore = asyncio.Semaphore(20)
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_one(session, semaphore) for _ in range(100)]
        results = await asyncio.gather(*tasks)
        print(sum(1 for r in results if r))

if __name__ == "__main__":
    asyncio.run(main())
这里有两个细节容易被忽略:一是并发数要受控,不要一口气开几千个任务;二是代理提取接口本身也有压力,如果 IP 池足够大,可以分次提取后在本地队列里取,减少接口调用次数。
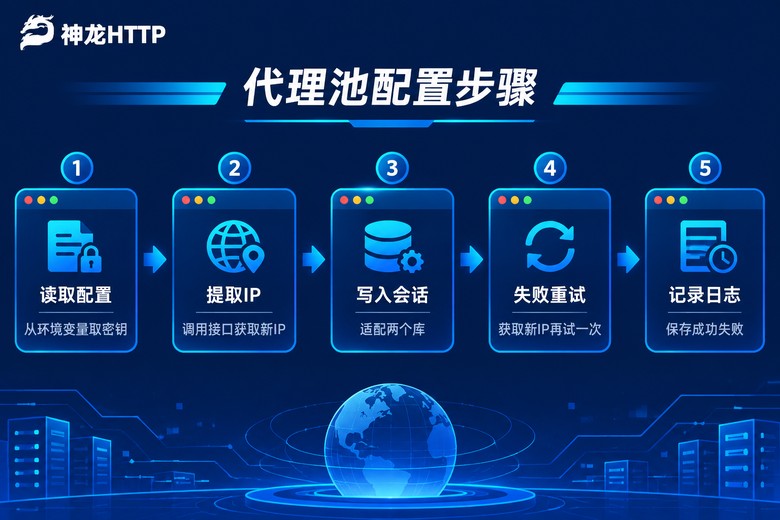
代理池配置流程:从环境变量到日志
真正落到项目里,我会把配置拆成四层:
- 密钥层:API 密钥、账号密码放环境变量,不进 Git。
- 提取层:按地区、数量、协议类型提取 IP,支持 HTTP/HTTPS/SOCKS5。
- 使用层:requests 用 proxies,aiohttp 用 proxy,统一超时和重试。
- 记录层:记录成功数、失败数、地区分布、平均耗时,方便判断代理质量。
神龙HTTP 的个人中心提供可视化用量统计与实时监控,可以识别异常、分析使用趋势。对于多项目共用代理池的场景,这一步比“代码能不能跑”更重要。
什么时候选择神龙HTTP
如果你的任务不是临时试一个 IP,而是长期跑公开数据采集、市场研究或 AI 大模型训练数据准备,代理池的稳定性会比单次速度更关键。神龙HTTP 提供短效动态 IP、长效静态 IP、固定 IP 代理等产品线,支持国内三大运营商正规授权,并有 3000 万+ 正规授权代理 IP 储备、可用率 99.9%、IP 纯度 99.8%、300+ 城市级精准定位等能力。对于 Python 项目来说,API 兼容主流爬虫编程语言,接入成本不高;技术团队 7×24 小时支持,也能减少线上排障时间。
选型时不必一次把所有特性都用满。先确定两件事:你要的是动态轮换还是固定出口;你要的是全国范围还是 300+ 城市级精准定位。再根据并发量决定提取策略。
常见问题
Q: Python3 使用代理 IP 时,requests 和 aiohttp 的参数为什么不一样?
A: requests 使用 proxies 字典,分别指定 http 和 https;aiohttp 通常使用 proxy 参数。两者底层处理方式不同,写代码时按对应库的参数名来即可。
Q: 代理池里的 IP 失败了,应该立刻重试还是获取新的 IP?
A: 建议先判断错误类型。超时、连接失败、代理不可用时,可以获取新的 IP 再试一次;如果是目标站点明确返回业务错误码,则不一定需要获取新的 IP,先检查请求参数和频率。
Q: aiohttp 高并发时,代理提取接口会不会成为瓶颈?
A: 会。如果任务量很大,可以分次提取 IP 放进本地队列,再用信号量控制并发;同时记录每个 IP 的成功率,避免反复消耗同一个不稳定 IP。
Q: 神龙HTTP 支持哪些协议?Python 里怎么配置?
A: 支持 HTTP/HTTPS/SOCKS5。Python 里 HTTP/HTTPS 代理通常写成 http://用户名:密码@IP:端口;SOCKS5 代理需要对应库支持,地址格式一般为 socks5://用户名:密码@IP:端口。具体字段以服务商 API 返回为准。