先别急着写代码,先把湖南本地生活数据拆成表
很多本地生活项目卡住,不是因为技术不会,而是地域边界没拆清。你要整理湖南餐饮门店的公开营业信息,还是家政维修的服务价格?是只看长沙一个商圈,还是覆盖岳阳、常德、衡阳多个城市?这些答案不同,湖南ip代理池的使用方式也不同。
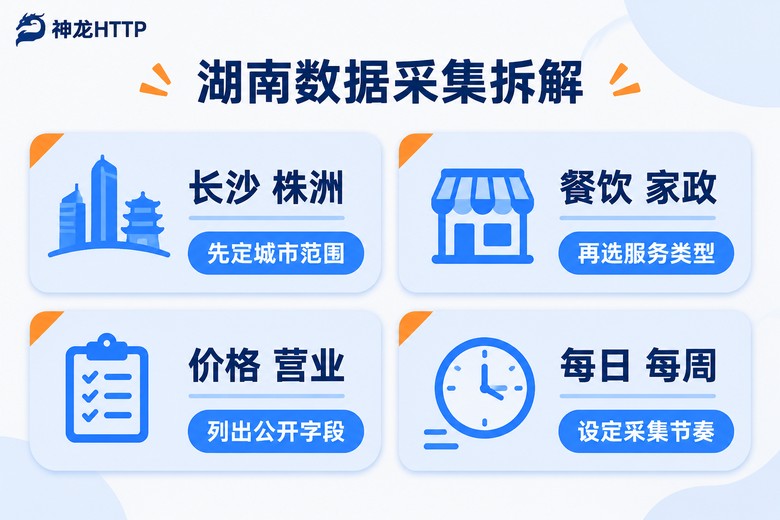
比较稳的做法,是先建一张“采集对象表”。表里至少要有城市、区县、服务类型、门店编号、公开字段、采集频率。比如同样是“门店”,餐饮门店看营业时间和套餐价,家政门店看服务范围和响应时间。字段定清楚,后面代理池怎么配、数据怎么校验,才不会出现城市混、门店混、时间混。
本地生活服务数据还有一个特点:它很依赖“位置”。一家门店在长沙五一广场,和同类型门店在株洲某个社区,门店密度、服务半径、价格带都可能不一样。所以地域定位不是锦上添花,而是决定数据能不能用的前提。
湖南地域定位可以拆成三层
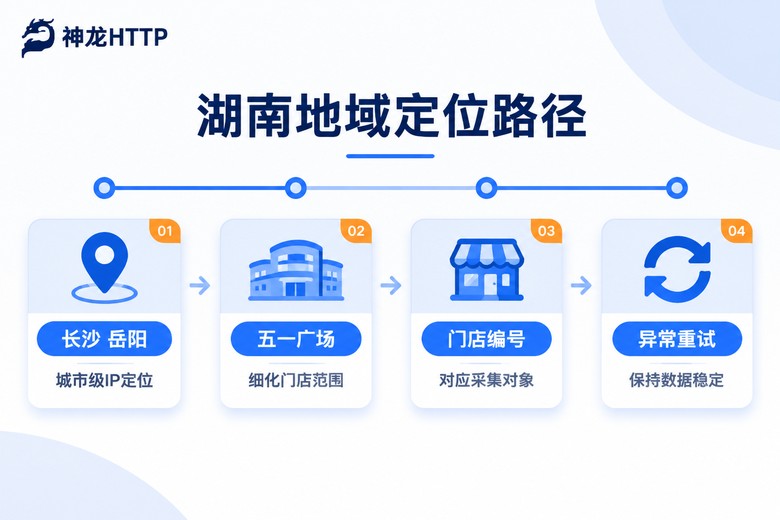
湖南本地生活数据采集,建议不要把所有页面都混在一个大池子里看。更清晰的方式,是按“城市—商圈—门店”三层来定位。
| 定位层级 | 示例 | 适合看什么 | 代理IP使用建议 |
|---|---|---|---|
| 城市级 | 长沙、株洲、湘潭 | 门店数量、平均价格、服务覆盖 | 每个城市单独分组,先跑大盘 |
| 商圈级 | 五一广场、步行街、大学城 | 门店密度、服务类型、区域差异 | 按商圈细化请求对象,保留片区标签 |
| 门店级 | 门店编号、地址、服务项 | 营业时间、价格、公开状态变化 | 对应到具体门店,结果单独存档 |
城市级解决“湖南整体有没有变化”;商圈级解决“这个片区门店多不多、类型全不全”;门店级解决“这家店的公开信息有没有更新”。三层数据分开存,后面做区域对比和单店监测会清楚很多。
如果你只关心全省趋势,城市级就够了。如果你要做门店运营分析,商圈级和门店级就要跟上。定位层级定错,后面再精细的清洗也会很费劲。
湖南ip代理池怎么配,才不容易乱
配置代理池时,核心不是“越多越好”,而是“定位越准越好”。湖南本地生活数据采集,我会先把城市作为第一分组:长沙、株洲、湘潭、岳阳、常德、衡阳等。每个城市单独维护一组可用代理,避免长沙的数据混进岳阳的结果里。
这样分组的好处很直接:一旦某个城市的数据出现异常,你能很快判断是页面本身变化,还是该城市的代理质量波动。如果所有城市共用一组代理,异常定位成本会高很多。
如果你要做长期公开数据整理,神龙HTTP这类正规授权代理IP服务会更省心。它支持300+城市级精准定位,湖南主要城市可以按城市分组使用;同时支持HTTP/HTTPS/SOCKS5,接入现有采集程序比较直接。对本地生活场景来说,城市定位稳定比单纯追求数量更重要。
这里还有一个细节:代理池不要只按“能不能用”来分,还要按“城市是否匹配”来分。一个代理即使状态正常,但如果城市标签不对,采回来的数据也可能不可比。所以城市匹配要放在前面,状态检查放在后面。
一个能落地的采集流程
实际操作可以按“先城市、后对象、再字段”的顺序来。先确定今天要看哪些城市,再确定每个城市采哪些公开页面,最后把结果写进对应门店表。请求节奏不要拉太满,页面返回异常时,先记录状态,再获取新的同城市代理稍等重试。
import requests

def fetch_page(page_url, proxy):
    headers = {"User-Agent": "LocalLifeBot/1.0"}
    resp = requests.get(
        page_url,
        proxies={"http": proxy, "https": proxy},
        headers=headers,
        timeout=10,
    )
    return resp

city_list = ["长沙", "株洲", "湘潭", "岳阳", "常德"]

for city in city_list:
    proxy = get_city_proxy(city)  # 调用神龙HTTP API,获取对应城市代理
    page_url = build_public_page_url(city)  # 目标公开页面地址
    result = fetch_page(page_url, proxy)
    print(city, result.status_code)
这段代码的重点不是某一行,而是把城市、代理、页面、结果四样东西绑在一起。每个城市用对应代理,每个结果保留城市标签和采集时间,后面排查问题时会快很多。
实际项目里,我还会在结果里加三个字段:城市、采集时间、数据版本。城市用于地域定位,采集时间用于判断新鲜度,数据版本用于区分同一家门店不同时间采回来的结果。这三个字段看起来不起眼,但后期做趋势分析时非常关键。
异常处理和数据校验
本地生活公开数据看起来简单,但门店信息经常有重复、缺字段、时间不一致。采回来后,至少做三类校验:一是城市标签是否对,二是门店编号是否唯一,三是采集时间是否完整。价格、营业时间这类字段,如果发现异常值,不要直接覆盖,先保留原始值,再人工或规则复核。
常见异常有几类。第一类是页面结构变化,导致字段取空;第二类是门店名称相似,导致重复匹配;第三类是城市标签错误,导致岳阳门店被记到长沙。前两类靠字段校验解决,第三类靠代理城市分组解决。
这里很依赖监控。神龙HTTP个人中心有可视化用量统计与实时监控,能看出哪个城市、哪个时段请求异常。技术团队也提供7×24小时支持,遇到代理可用率波动或接入问题,可以更快定位。数据项目最怕“采回来了但不知道哪条可信”,监控和留痕就是为了解决这件事。
建议把异常日志和原始结果分开存。原始结果保留页面返回内容,异常日志记录状态码、城市、代理、重试次数。这样即使某次采集失败,你也能判断是偶发问题,还是某个城市长期不稳定。
常见问题
Q: 湖南ip代理池一定要按城市分组吗?
A: 不一定,但本地生活数据建议按城市分组。城市级看大盘,商圈级看密度,门店级看单店变化。分组后异常更容易定位,数据也更容易做区域对比。
Q: 本地生活服务数据多久采一次合适?
A: 营业时间、价格、套餐这类变化快的公开信息,可以每日看;趋势和区域对比可以每周看。不要为了追时效把节奏拉得太满,稳定比快更重要。
Q: 某个城市失败率突然升高怎么办?
A: 先看城市匹配是否正确,再看请求节奏是否过密。可以获取新的同城市代理,加入重试和稍等再试机制。用神龙HTTP个人中心看用量统计与实时监控,能快速发现异常时段。
Q: 如何判断采回来的数据对应到正确门店?
A: 用门店编号、地址、服务类型、营业状态做交叉核对。同一城市不同门店不要共用同一组结果,字段里保留采集时间和城市标签,方便后续追溯。