先别急着写代码,先把“提取”拆成四件事
做过公开数据采集的人都知道,代理IP提取不是点一下按钮那么简单。一次稳定任务至少要看四件事:从哪个城市取、用什么协议、拿到后是否真的可用、失败后怎么补位。很多项目一开始把精力放在“怎么拿到IP”上,结果上线后才发现,城市不匹配、超时没处理、异常没记录,任务跑着跑着就卡住。
所以,先把代理IP提取当成一条小流水线来设计:参数准备、请求接口、状态校验、入库复用。这样后面做自动化调度时,才不会出现“代码能跑,但任务不稳”的情况。
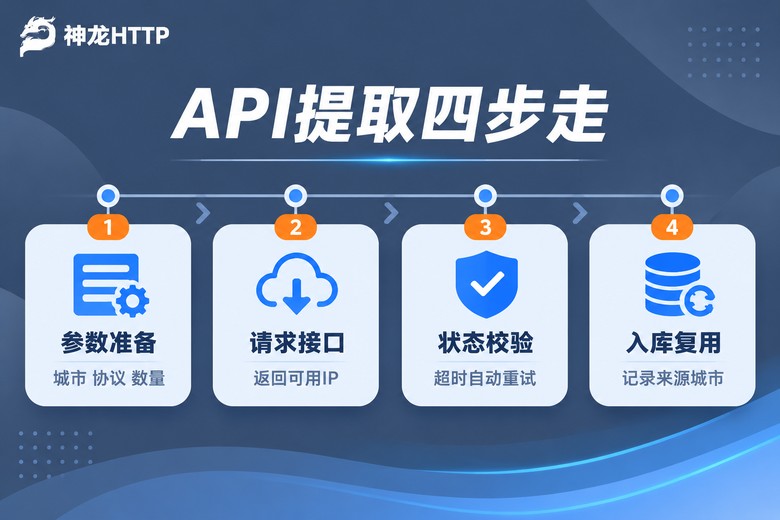
API提取的最小可用流程
用神龙HTTP做提取,核心思路很直接:把任务需要的城市、协议、数量写进请求参数,调用API后拿到可用IP。如果你刚开始接触,建议先跑通一个最简流程,再慢慢加城市池、重试和监控。
import requests

API_KEY = "你的API密钥"
API_ENDPOINT = "神龙HTTP 提供的API地址"

def extract_one(city="300", protocol="HTTP"):
    payload = {
        "key": API_KEY,
        "city": city,
        "protocol": protocol,
        "limit": 1
    }
    resp = requests.post(API_ENDPOINT, json=payload)
    resp.raise_for_status()
    data = resp.json()

    if data.get("code") != 0:
        raise RuntimeError(data.get("msg"))

    return data["data"]["ip"]

ip = extract_one(city="300", protocol="HTTP")
print(ip)
这段代码只解决“能不能拿到”。真正上任务时,还要判断返回状态、响应时间、城市是否一致。如果接口返回成功但实际请求目标失败,就要把这次结果标记为异常,而不是直接当成可用。
参数怎么配:城市、协议、数量、有效期
参数配置看起来简单,但直接影响任务成功率。城市定位是最容易被忽略的一项。神龙HTTP支持300+城市级精准定位,如果你的任务面向某个地区的公开数据,把城市参数配准,比盲目多取IP更稳。
协议方面,按项目需要选择 HTTP、HTTPS 或 SOCKS5。如果目标站点是普通公开接口,HTTP 通常够用;如果链路对加密要求更高,就选 HTTPS;如果项目需要更底层的网络能力,再考虑 SOCKS5。数量上,不建议一次取太多。任务节奏快就少量多次取,任务节奏慢就按周期补,避免资源闲置。
| 参数 | 常见配置 | 适用场景 |
|---|---|---|
| 城市 | 目标地区城市码 | 公开数据采集、市场研究 |
| 协议 | HTTP / HTTPS / SOCKS5 | 按项目链路要求选择 |
| 数量 | 1个起,按任务节奏增加 | 低频任务、高频任务 |
| 有效期 | 短效、长效按任务周期定 | 高频任务、固定任务 |
这里有个实用做法:给每个任务建立“参数快照”。把城市、协议、数量、有效期、重试次数都记下来。后面排查问题时,不用猜“当时到底用了哪个参数”,直接看快照就行。
自动化调度:让任务自己排队、重试、监控
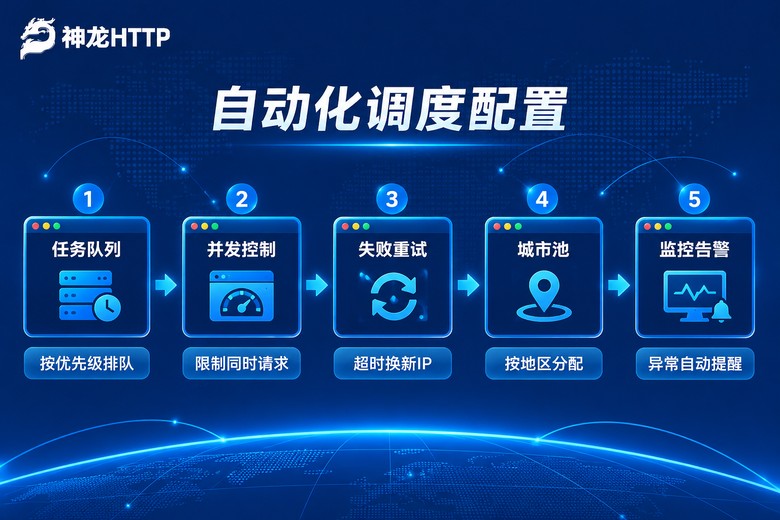
当任务从“跑一次”变成“长期跑”,手动提取就会变成负担。自动化调度的目的,不是让代码更复杂,而是把重复操作交给系统:任务进队列、按并发取IP、失败自动补位、结果自动记录。
- 任务队列:把每个采集任务拆成独立单元,按优先级排队,避免高优先级任务被低优先级任务堵住。
- 并发控制:限制同时请求数,先小流量验证,再逐步提高。并发不是越高越好,稳定比速度更重要。
- 失败重试:遇到超时或异常,先短暂等待再获取新的IP。如果同一城市连续失败,就换个地区的IP,或者把任务放回队列稍后处理。
- 城市池:把可用城市按任务目标分组,避免所有任务都挤在同一个城市,造成资源紧张。
- 监控告警:记录成功率、平均响应时间、异常城市,方便及时发现链路问题。
import time
from collections import deque

city_pool = ["300", "301", "302"]
task_queue = deque([
    {"task_id": 1, "city": "300"},
    {"task_id": 2, "city": "301"},
    {"task_id": 3, "city": "302"},
])

def run_task(task, retry=2):
    last_error = None
    for attempt in range(retry + 1):
        try:
            ip = extract_one(city=task["city"])
            return {"task_id": task["task_id"], "ip": ip, "status": "ok"}
        except Exception as e:
            last_error = str(e)
            time.sleep(1 + attempt)
    return {"task_id": task["task_id"], "ip": None, "status": "fail", "error": last_error}

def scheduler():
    results = []
    while task_queue:
        task = task_queue.popleft()
        results.append(run_task(task))
    return results

results = scheduler()
这个调度器还比较朴素,实际项目里可以再增加“失败城市冷却”“任务优先级”“结果入库”等能力。关键是每一步都要有日志,方便复盘。比如某次成功率下降,到底是某个城市异常,还是接口响应变慢,日志能直接给答案。
用神龙HTTP把提取链路做稳
代理IP提取能不能稳,资源池本身很关键。神龙HTTP有3000万+正规授权代理IP储备,可用率99.9%,IP纯度99.8%,支持HTTP/HTTPS/SOCKS5。对长期跑任务的项目来说,这意味着你不用把太多精力花在“这个IP还能不能用”上,而是把精力放在任务逻辑本身。
另一个值得展开的是API集成体验。神龙HTTP的API兼容主流爬虫编程语言,提供文档与示例代码,技术团队提供7×24小时支持。如果你团队里有人熟悉 Python、Java、Go 等语言,接入成本并不高。先把示例代码跑通,再替换成自己的参数和任务队列,通常一两天就能搭出可用链路。
除了提取,还要看监控。神龙HTTP个人中心提供可视化用量统计与实时监控,可以识别异常、分析使用趋势。对自动化调度来说,这类数据非常实用:你能看到哪个城市调用频繁、哪类任务失败率高、什么时候响应时间变长。发现问题早,调整参数也快。
适用场景上,神龙HTTP适合公开数据采集、AI大模型训练、市场研究等需要稳定IP资源的场景。如果你的任务对城市定位和并发稳定性有要求,这类资源池会比零散IP更省心。
常见问题
Q: 代理IP怎么提取最快?
A: 最快的方式是用API按任务参数直接取。先固定城市、协议、数量,跑通最小流程,再根据任务节奏增加并发和重试。不要一开始就追求高并发,稳定拿到可用IP比单纯速度更重要。
Q: 提取失败怎么办?
A: 先判断失败类型。接口返回异常,就看状态码和错误信息;接口成功但实际请求失败,就标记为异常并获取新的IP。如果某个城市连续失败,可以换个地区的IP,或者把任务放回队列稍后重试。
Q: 城市定位怎么配更稳?
A: 按任务目标地区配置。神龙HTTP支持300+城市级精准定位,公开数据采集和市场研究任务可以把城市参数配得尽量贴近目标地区。如果任务跨区域,就建立城市池,按地区分配任务,避免所有任务都集中在一个城市。
Q: 怎么判断代理IP是否可用?
A: 至少看三项:接口是否返回成功、实际请求目标是否成功、响应时间是否在可接受范围内。建议把可用结果入库,并记录城市、协议、获取时间。后面做调度时,就能根据历史表现调整城市池和重试策略。