先判断:你的爬虫是不是真的需要代理IP
写Python爬虫时,很多人一开始直接裸奔请求。跑了几百条数据没问题,跑到几千条就开始出现403、429、连接超时,或者同一个接口反复返回空数据。这时候再硬加线程,往往只会让请求更不稳定。
代理IP不是“越多加越好”,而是要看你的采集任务属于哪一类。下面这张表可以先做个判断:
| 任务特征 | 是否建议用代理IP | 原因 |
|---|---|---|
| 请求量小,目标站点访问宽松 | 可先用本机IP | 先观察响应状态和耗时 |
| 频繁返回403、429或空页面 | 建议接入代理IP | 分散请求来源,降低集中限流 |
| 需要不同城市来源数据 | 建议用城市定位IP | 让请求来源更接近目标区域 |
| 长时间跑公开数据采集 | 建议用短效动态IP | IP有效期短,来源更分散 |
如果任务只是验证接口、调试字段,先不用代理。等请求量上来、异常率明显升高,再接入IP池,成本会更可控。
requests接入代理IP:从单条到IP池
requests里接入代理IP,核心就两件事:把代理写进 proxies,再决定这条代理从哪里来。单条代理适合调试,IP池适合正式任务。
单条代理可以这样写:
import requests

TARGET_URL = "target_url_placeholder"  # 替换为公开接口地址
PROXY = "proxy_placeholder"  # 例如 scheme://user:pass@host:port

proxies = {
    "http": PROXY,
    "https": PROXY,
}

resp = requests.get(
    TARGET_URL,
    proxies=proxies,
    timeout=15,
    headers={"User-Agent": "Mozilla/5.0"}
)
print(resp.status_code)
这里的 timeout 很重要。代理链路比直连多了一跳,网络波动时如果不设超时,程序容易卡住。正式任务里,建议同时给连接建立和数据读取设置明确时间。
如果代理需要账号密码,通常写在代理地址里。如果神龙HTTP给你的接口返回的是纯地址,就按返回格式拼接;如果返回的是带鉴权信息,就直接使用。不要手动拼错协议,HTTP代理和HTTPS代理在requests里可以分别配置。
正式跑的时候,不要固定一条代理。可以每次请求前获取新的IP,避免同一个来源被目标站点识别。下面是一个简化示例:
import requests

TARGET_URL = "target_url_placeholder"
PROXY_API = "SHENLONG_PROXY_API"
API_PARAMS = {"type": "dynamic"}

session = requests.Session()

def get_proxy():
    # 调用神龙HTTP接口获取新的IP
    resp = session.get(PROXY_API, params=API_PARAMS, timeout=10)
    resp.raise_for_status()
    return resp.json()["proxy"]

for i in range(20):
    proxy = get_proxy()
    proxies = {
        "http": f"http://{proxy}",
        "https": f"http://{proxy}",
    }
    resp = session.get(TARGET_URL, proxies=proxies, timeout=15)
    print(i, resp.status_code)
这里有两个细节容易被忽略。第一,每次获取新的IP 不等于完全无风险,还要控制并发和请求间隔。第二,代理接口本身也要设超时,不然IP获取失败会拖慢整个爬虫。
Scrapy中间件配置:让代理IP跟着请求走
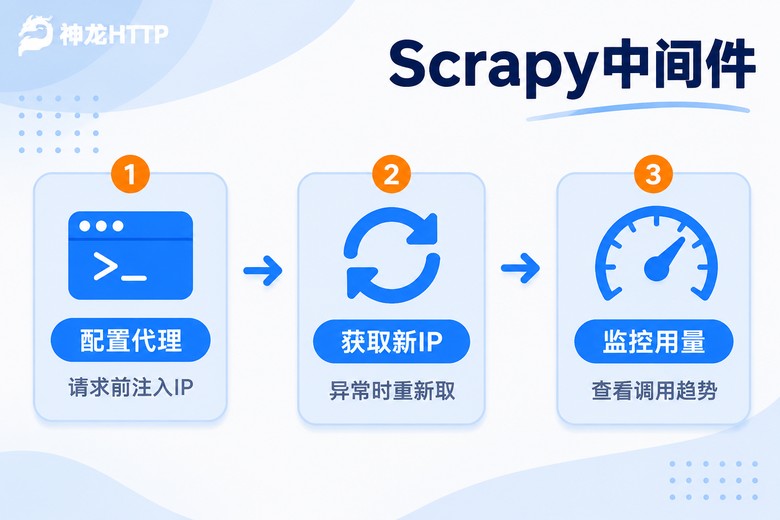
Scrapy里不建议在每个Spider里手动写代理,这样代码会散掉。更稳的做法是写一个下载中间件,让每个请求在下载前统一注入代理IP。
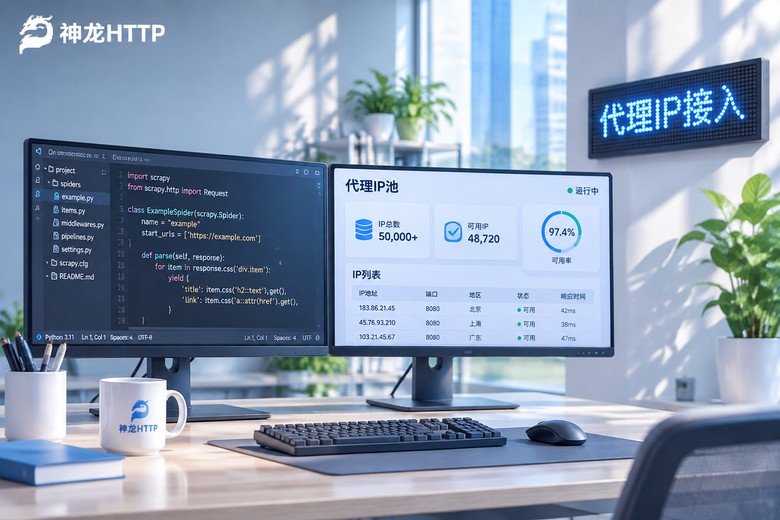
下面是一个轻量版中间件。它的思路是:请求进入下载器之前,从神龙HTTP接口获取新的IP,并写入 request.meta。如果Scrapy触发重试,中间件会再次执行,重新获取新的IP。
# middlewares/shenlong_proxy.py
import random
from scrapy import signals

class ShenlongProxyMiddleware:
    def __init__(self, proxy_api, proxy_type="dynamic"):
        self.proxy_api = proxy_api
        self.proxy_type = proxy_type

    @classmethod
    def from_crawler(cls, crawler):
        proxy_api = crawler.settings.get("SHENLONG_PROXY_API")
        proxy_type = crawler.settings.get("SHENLONG_PROXY_TYPE", "dynamic")
        middleware = cls(proxy_api=proxy_api, proxy_type=proxy_type)
        crawler.signals.connect(middleware.spider_opened, signal=signals.spider_opened)
        return middleware

    def spider_opened(self, spider):
        spider.logger.info("Shenlong proxy middleware started")

    def process_request(self, request, spider):
        proxy = self._get_proxy()
        request.meta["proxy"] = f"http://{proxy}"
        request.meta["proxy_type"] = self.proxy_type

    def _get_proxy(self):
        # 这里调用神龙HTTP接口获取新的IP
        # 实际项目里可以加本地池、失败重试和异常日志
        return "proxy-host:port"
然后在 settings.py 里启用中间件,并配置重试参数:
DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.shenlong_proxy.ShenlongProxyMiddleware": 540,
}

SHENLONG_PROXY_API = "SHENLONG_PROXY_API"
SHENLONG_PROXY_TYPE = "dynamic"

RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [403, 408, 429, 500, 502, 503, 504]

CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 4
DOWNLOAD_DELAY = 1
这里 RETRY_HTTP_CODES 很关键。默认重试不一定覆盖403和429,如果你的目标站点常用这两个状态码做限流,需要手动加进去。重试次数也不要盲目拉满,3到5次通常足够,超过之后大概率是目标接口本身有问题,或者代理来源不够分散。
如果项目里已经有代理池,也可以把 _get_proxy 改成从本地池里取。池子空了再调用神龙HTTP接口补充。取IP时建议做随机,不要总是从头开始,这样来源分布会更均匀。
def _get_proxy(self):
    if not self._pool:
        self._fetch_proxies()
    return random.choice(self._pool)

def _fetch_proxies(self):
    # 调用神龙HTTP接口补充多个IP
    self._pool = ["proxy-host-1:port", "proxy-host-2:port"]
注意,本地池只适合短任务或代理有效期比较长的场景。短效动态IP如果有效期很短,池子放太久会出现过期IP。正式任务里,最好把“获取时间”“过期时间”“使用次数”一起记录,过期就丢弃。
神龙HTTP怎么接:短效动态和固定IP怎么选
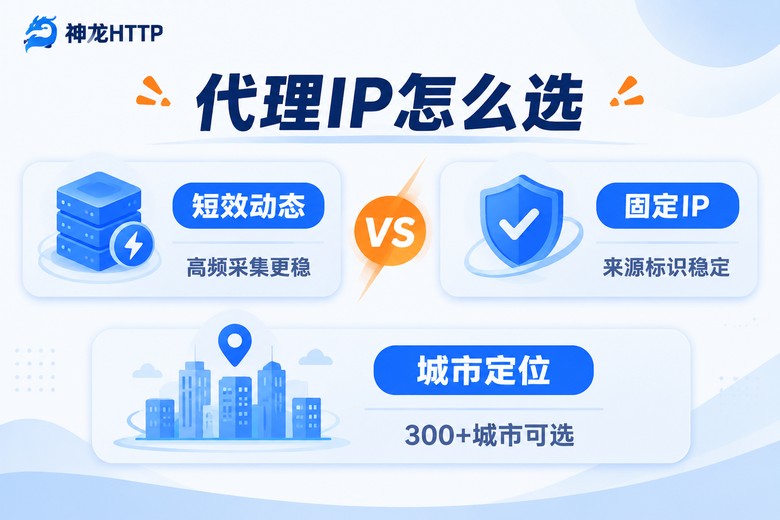
很多Python项目不是缺代理,而是缺一个稳定的IP来源。神龙HTTP提供短效动态IP、长效静态IP和固定IP代理,覆盖公开数据采集、市场研究、AI大模型训练等场景。选型时不用纠结太多,主要看两点:请求来源是否需要稳定,以及任务跑多久。
| 需求 | 更适合的产品 | 使用感受 |
|---|---|---|
| 高频采集、请求量大 | 短效动态IP | 来源分散,适合长时间任务 |
| 需要同一来源标识 | 长效静态IP / 固定IP代理 | 来源更稳定,适合持续性任务 |
| 需要指定城市来源 | 城市定位IP | 可按城市级定位选择 |
对大多数Python爬虫来说,短效动态IP是最常用的选择。它的特点是IP有效期短、来源更新快,适合公开数据采集这类需要持续请求的任务。神龙HTTP的API可以兼容主流爬虫编程语言,你不用在Scrapy里写复杂逻辑,直接通过接口获取新的IP,再注入请求即可。
另一个容易被忽略的好处是监控。个人中心里有可视化用量统计和实时监控,可以看到调用趋势、异常情况和资源使用状态。爬虫跑久了,最怕的不是某一次失败,而是不知道IP池什么时候开始变差。有监控之后,排障会快很多。
常见问题
Q: requests里 proxies 的 http 和 https 有什么区别?
A: 简单理解,http 代理用于请求HTTP地址,https 代理用于请求HTTPS地址。很多代理地址两个字段可以写同一个值,但协议前缀要写对。如果目标站点是HTTPS,建议重点检查 https 字段。
Q: Scrapy中间件里为什么要把代理写进 request.meta?
A: request.meta 是Scrapy给单个请求携带上下文的常用位置。把代理写进去,后续中间件、日志和重试逻辑都能读取。这样代理配置不会散落在Spider代码里,也方便排查某一条请求用了哪个IP。
Q: 代理IP获取速度跟不上请求速度怎么办?
A: 先降低并发,再检查代理接口耗时。正式任务里可以维护一个本地IP池,池子不足时再获取多个IP。同时给获取接口设置超时,避免一条慢请求拖住整个下载器。
Q: 什么时候该用固定IP,而不是短效动态IP?
A: 当任务需要同一来源标识、请求频率不高、或者目标接口对来源连续性更敏感时,固定IP或长效静态IP更合适。如果任务是高频公开数据采集,短效动态IP通常更稳。