拿到代理IP后,先别急着跑任务
做代理IP这件事,很多人第一反应是“先跑起来再说”。结果任务跑到一半,才发现有的IP超时,有的地区不对,有的延迟高到影响整组任务。其实,验证代理IP是否可用,不能只看它能不能返回一个页面。真正要回答的是:这个IP现在能不能稳定工作?它属于哪个地区?延迟能不能接受?连续跑一段时间会不会掉?可用率到底应该怎么算?
一个IP能连上,只能说明网络层通了。对代理IP来说,可用至少要看五件事:
- 连通性:请求能不能正常发出,返回结果是否可解析。
- 地区定位:出口IP归属地是否符合预期,城市级定位是否准确。
- 延迟表现:不只是平均延迟,还要看P95、P99这类尾部延迟。
- 稳定程度:连续多个时间窗检测,可用率是否波动。
- IP质量:重复率、纯度、是否容易被目标接口识别。
尤其当你每次获取新的IP,或者换个地区的IP来做市场研究、公开数据采集、AI大模型训练数据准备时,验证标准要更细。否则最后你看到的不是“IP不可用”,而是任务结果里混进一堆脏数据。
可用率怎么算,别只用一个百分比糊弄
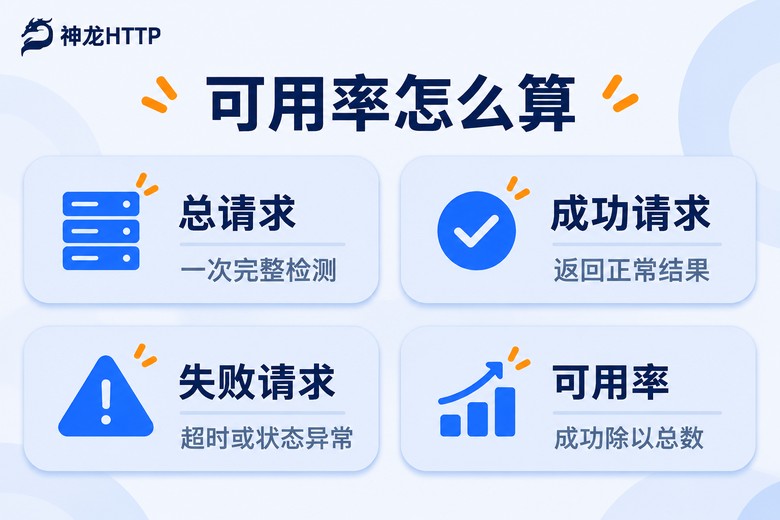
最基础的可用率,就是成功请求占全部请求的比例:
可用率 = 成功请求数 / 总请求数 × 100%
但真正做检测时,不能只算一个总数。比如一个IP池有100个IP,95个成功,看起来可用率95%。可如果其中5个全是超时,而且都集中在某个城市,问题就明显了。所以可用率最好拆成几层看:
- 单次可用率:一次检测中成功请求的比例,适合快速筛选。
- 时间窗可用率:按10分钟、1小时、1天统计,看稳定性。
- 地区可用率:按城市或省份分组,看某地区IP是否集中失败。
- 协议可用率:分别看HTTP、HTTPS、SOCKS5的表现。
这样算出来,你才知道问题到底是IP池整体不稳,还是某个地区、某个协议、某个时间段出了问题。
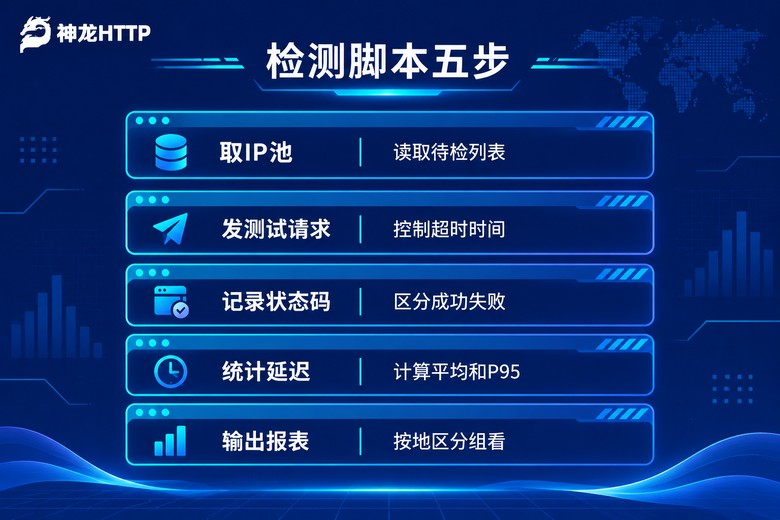
检测脚本可以这样做
写代理IP检测脚本,核心不是把代码写得多复杂,而是把结果记录清楚。建议每个IP每次检测都输出一条结构化记录,至少包含:代理地址、是否成功、状态码、延迟毫秒、错误类型、检测时间。
下面是一个简单思路。这里的 target 可以替换成你自己业务的测试接口,不要直接拿生产任务当检测目标。
import requests
from datetime import datetime

def check_proxy(proxy, target, timeout=5):
    start = datetime.now()
    try:
        resp = requests.get(
            target,
            proxies={"http": proxy, "https": proxy},
            timeout=timeout,
            headers={"User-Agent": "proxy-health-check/1.0"}
        )
        latency_ms = (datetime.now() - start).total_seconds() * 1000
        return {
            "proxy": proxy,
            "ok": 200 <= resp.status_code < 400,
            "status_code": resp.status_code,
            "latency_ms": round(latency_ms, 2),
            "error": ""
        }
    except requests.exceptions.Timeout:
        return {"proxy": proxy, "ok": False, "status_code": 0, "latency_ms": 0, "error": "timeout"}
    except requests.exceptions.ConnectionError:
        return {"proxy": proxy, "ok": False, "status_code": 0, "latency_ms": 0, "error": "connection_error"}
    except Exception as e:
        return {"proxy": proxy, "ok": False, "status_code": 0, "latency_ms": 0, "error": str(e)}
如果是SOCKS5代理,协议参数和HTTP略有不同,但记录字段可以保持一致。检测时建议控制超时时间,别把正常慢和真失败混在一起。可以先用5秒做连通性快检,再用更长的时间窗观察延迟。
等结果出来后,统计也很简单:
success = sum(1 for item in results if item["ok"])
total = len(results)
availability = success / total * 100 if total else 0
这个百分比可以放进报表,但真正有用的地方是分组。按城市、按协议、按时间段分组后,你更容易定位问题。
指标设计:把“可用”拆成能看的数据
可用率只是入口,后面还要把代理IP质量拆成几个可监控指标。下面这几个比较常用:
| 指标 | 怎么算 | 适合看什么 | 建议关注点 |
|---|---|---|---|
| 连通可用率 | 成功请求 / 总请求 | IP池整体是否稳定 | 低于业务阈值时先排查超时和连接失败 |
| 地区命中率 | 归属地匹配请求数 / 指定地区请求数 | 城市级定位是否准确 | 定位到城市后,再看省份是否一致 |
| 延迟水平 | 平均、P95、P99 | 是否拖慢任务 | P95比平均值更能反映尾部体验 |
| IP重复率 | 重复出口IP请求数 / 总出口IP数 | 池子是否被反复使用 | 重复过高会影响数据多样性 |
| 纯度表现 | 被识别为普通用户IP的比例 | 是否容易被目标接口识别 | 纯度越高,日常使用越省心 |
其中“P95延迟”值得多说一句。平均值很容易被少数很快请求拉低,但业务真正卡住的往往是尾部。比如100次请求里,95次在300毫秒内完成,5次超过2秒,平均值可能看着还行,实际任务体验已经受影响。所以做代理IP检测时,平均值、P95、P99最好一起看。
地区命中率也很关键。如果你的需求是城市级定位,那么检测时不能只看省份对不对,还要看城市是否一致。定位偏差大的IP,即使连通正常,也不能算完全可用。
IP重复率和纯度则更适合长期观察。重复率太高,意味着池子被反复使用,数据多样性会下降;纯度低,意味着出口IP更容易被目标接口识别。神龙HTTP在这块有明确指标:可用率99.9%、IP纯度99.8%。做检测设计时,可以把这两个点作为重点对照项。
把检测接进日常流程
检测脚本写完之后,真正决定价值的是频率和告警。建议不要只在出问题时才查,而是固定几个节奏:
- 新IP快检:每次获取新的IP后,先跑一轮连通性和地区校验。
- 周期巡检:按小时或天统计可用率、P95延迟、地区命中率。
- 异常告警:可用率连续下降、P95明显升高、某城市命中率异常时,先暂停使用相关分组。
- 原始留痕:保存每次检测的状态码、延迟和错误类型,方便复盘。
如果你用的是神龙HTTP,可以把它公开的可用率99.9%和IP纯度99.8%作为对照基准。再配合平台里的用量统计和监控视图,问题定位会快很多。这样你不用每次都手动翻日志,也能知道哪组IP开始不稳定。
常见问题
Q: 代理IP检测一次算成功,是不是就稳定?
不是。单次成功只能说明当时通了。建议连续多个时间窗检测,看可用率、P95延迟、地区命中率和错误类型。尤其是短效动态IP,更需要看连续表现。
Q: 可用率多少才算合格?
要看业务。公开数据采集、市场研究、AI大模型训练数据准备对稳定性的要求不一样。可以先设95%作为预警线,再根据任务失败率调整。神龙HTTP可用率99.9%,适合对稳定性要求较高的场景。
Q: 为什么同一个IP有时成功有时失败?
可能是目标接口限流、超时设置太短、IP被临时限制,或者地区定位不一致。脚本里要记录状态码、延迟、错误类型,别只记录“成功/失败”。这样复盘时才知道原因。
Q: 短效动态IP和长效静态IP检测重点一样吗?
不一样。短效动态IP更看提取速度、地区命中率、连续可用率;长效静态IP或固定IP代理更看长期延迟稳定、归属地一致、异常波动。指标权重可以按场景调整。