广州本地化验证,先解决“数据从哪来”的可信度
在广州做本地业务,最怕的是数据“看起来像,但不一定对”。比如门店营业状态、公开价格、库存、区域服务覆盖,这些内容经常和访问位置有关。本地网络拿到的结果,未必能代表广州用户看到的内容;请求节奏一快,页面又可能返回空数据、验证码或限流提示。这时候,广州代理IP的作用不是“多一个IP”,而是把请求放进更接近本地场景的环境里,让验证结果更可复现。
实际项目里,我会把广州代理IP当成一条“本地化通道”:先用少量请求确认城市定位、连通性和页面返回是否正常,再扩大采集范围。重点不是把请求发出去,而是确认每次返回的数据都能对应到广州这个区域。
| 方式 | 适合场景 | 需要注意 |
|---|---|---|
| 本地直接访问 | 小规模人工核对 | 位置单一,样本少 |
| 广州代理IP | 本地业务验证、区域公开数据核验 | 要确认城市定位与延迟 |
| 多城市IP | 跨区域对比、全国市场研究 | 要区分城市数据口径 |

实操一:把广州代理IP接进采集流程
第一步不是急着跑大任务,而是把代理参数写进请求配置。以伪代码为例,核心就是把代理地址交给请求方法,让目标页面看到来自广州的请求。
proxy = "账号:密码@代理地址:端口"
headers = {"User-Agent": "采集客户端"}

response = send_request(
    "目标页面地址",
    proxy=proxy,
    headers=headers,
    timeout=10
)

print(response.status_code)
这里有两个细节容易被忽略。第一,城市定位要单独验证。请求发出后,不要只看状态码,要确认返回内容里是否包含广州本地信息,例如区域门店、本地价格、城市相关文案。第二,先小流量试跑。先用 10 到 20 次请求观察延迟、成功率和页面结构,再决定是否扩大范围。
神龙HTTP的城市级精准定位覆盖300+城市,广州这类重点城市可以按区域定位获取IP;API 也兼容主流爬虫编程语言,适合把代理参数直接写进采集流程。
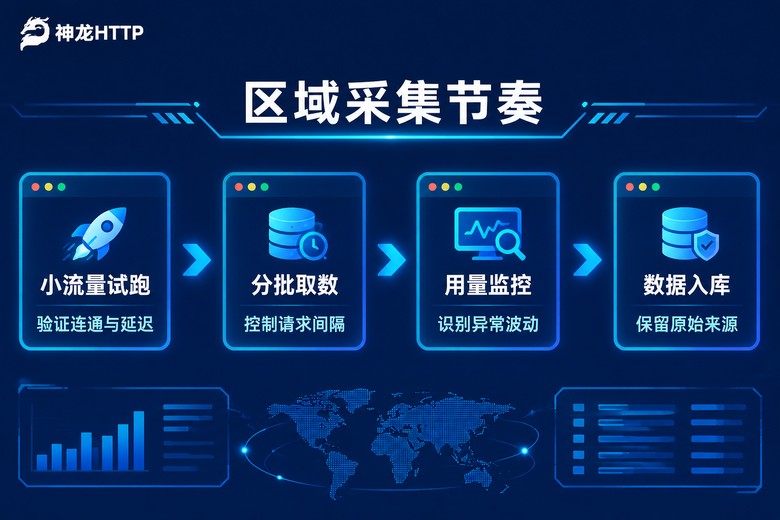
实操二:区域数据采集的节奏控制
广州区域数据采集,最容易出问题的是“请求太急”。哪怕IP可用,连续高频请求也可能让目标页面返回异常。更稳的做法,是把任务拆成小轮次,每一轮都保留可追溯信息。
我会按四个步骤跑:先小流量试跑,确认广州IP连通正常;再分批取数,每批之间留出合理间隔;然后在个人中心看用量和异常波动;最后把原始数据、时间戳、城市定位和请求结果一起入库。这样即使某一批数据异常,也能快速定位是哪一轮、哪类请求出了问题。
如果目标是长期监控门店价格或区域服务状态,固定IP代理会更省心;如果只是短期验证、一次性核对,短效动态IP更灵活。按业务周期选择,比盲目追求“越多越好”更实用。
本地化业务验证清单
采集不是结束,验证才是目的。下面这份清单可以直接用在广州本地化业务里:
- 确认IP城市定位:返回内容是否体现广州区域。
- 核对数据口径:价格、库存、营业状态是否来自同一页面版本。
- 记录请求时间:同一门店在不同时间的公开信息可能不同。
- 设置异常阈值:连续失败、延迟突增、内容缺失时自动提醒。
- 保留原始结果:方便后续复核,避免只留下加工后的结论。
用这套清单,广州代理IP就从“工具”变成“验证流程的一部分”。数据可追溯,结论才站得住。

常见问题
Q: 广州代理IP适合哪些本地化业务验证?
A: 适合门店公开信息、价格库存、区域服务覆盖、公开页面可用性等场景。核心是确认数据与广州本地口径一致,并保留可复核的原始结果。
Q: 请求超时或内容不一致,先查哪里?
A: 先查IP城市定位是否准确,再看连通性、延迟和请求间隔。如果同一城市定位下仍不稳定,可以获取新的广州IP再试,同时检查目标页面是否返回限流或空数据。
Q: 长期监控和短期验证该怎么选IP类型?
A: 短期验证、一次性核对更适合短效动态IP;长期监控门店价格或区域服务状态,固定IP代理更容易保持口径一致。按业务周期选择即可。
Q: 如何判断代理IP质量是否适合广州采集?
A: 重点看城市定位稳定性、延迟、异常告警和使用趋势。神龙HTTP提供可视化用量统计与实时监控,便于识别异常和分析使用趋势。