上个月帮朋友的团队处理一个公开数据采集项目,他们的程序直连目标网站跑了两天,请求频率一高就被限制,整个任务卡住不动。我的建议是把出口收拢到一台自己控制的代理服务器上——所有请求从同一个地方出去,频率可控、日志可查。这篇文章就把整个过程完整写一遍,从买服务器到最终上线验证,照着做大概半天能跑通。
动手前先想明白:自建代理能给你什么
很多人卡住的不是技术,而是预期。自己搭的代理服务器,本质是把一台云服务器变成你专属的出口:所有请求从它的IP出去,规则你定,日志你看。优势是稳定、可控、独享,适合需要固定出口的业务,比如公司采集任务的统一出口、内部流量的统一审计。
但它也有天然的边界:一台服务器就一个出口IP,想要更多不同地区的IP,就得一台一台加机器,成本和维护量跟着涨。所以自建适合"要一个稳定可控的出口"这种需求,如果你要的是源源不断获取新的IP,文末会讲到更省力的路子。
第一步:准备服务器,别买贵了
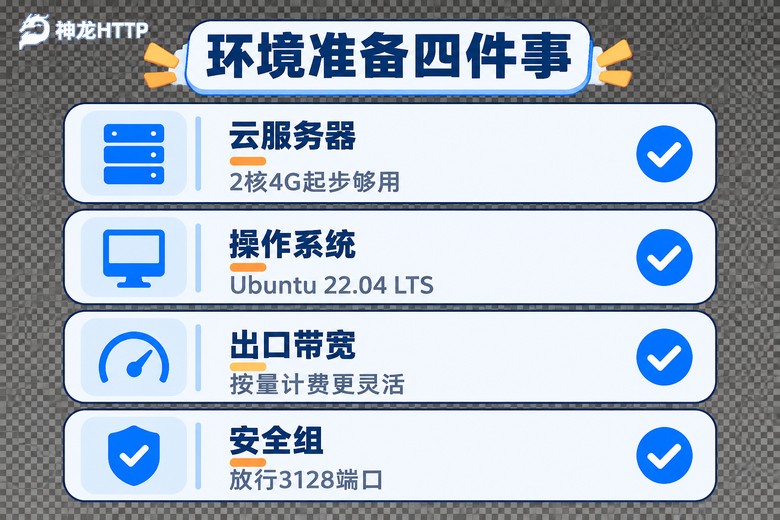
配置不用纠结。Squid这类代理软件本身极轻量,2核4G、40G系统盘的入门款足够支撑日常采集任务,真正吃紧的是带宽——代理服务器是所有流量的中转站,出入都算钱。建议选按量计费的带宽模式,跑小任务一个月也就几十块;长期大流量再考虑固定带宽包。
地域选择有个小技巧:代理服务器离目标网站越近、离你自己越近,延迟越低。拿不准就先开一台按量计费的,实测延迟之后再决定要不要选别的地域。
系统推荐 Ubuntu 22.04 LTS,教程多、软件源全。开机后先做三件事:
# 1. 更新系统补丁
sudo apt update && sudo apt upgrade -y

# 2. 创建普通用户,禁用root直接登录
sudo adduser deploy

# 3. 在云控制台的安全组里放行端口
#    22端口:只放行你自己的办公网络出口IP
# 3128端口:Squid默认端口,后面会用到安全组这步最容易被忽略。我见过有人把3128端口对全网开放又没设认证,第二天服务器流量就被蹭光了。记住一个原则:端口能限多窄就限多窄。
第二步:装Squid,十几行配置跑起来
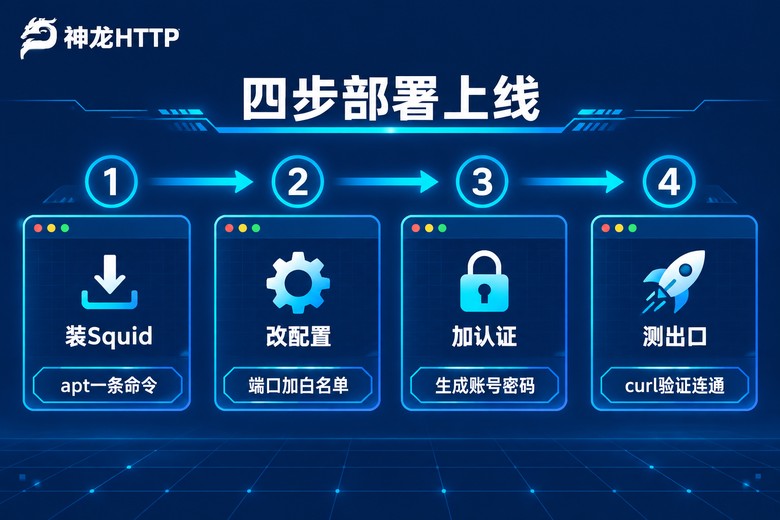
代理软件的选择不少,Squid是老牌且文档最全的一个,生产环境用得也多。一条命令装好:
sudo apt install squid -y装完编辑主配置文件 /etc/squid/squid.conf,核心就这几行:
# 监听端口
http_port 3128

# 只允许你的服务器或办公网络访问(把1.2.3.4换成你的出口IP)
acl allowed_clients src 1.2.3.4/32
http_access allow allowed_clients

# 其余请求全部拒绝,务必放在最后
http_access deny all

# 隐藏真实客户端信息,减少指纹暴露
forwarded_for delete
via off
保存后重载服务:
sudo systemctl reload squid
sudo systemctl enable squid   # 设为开机自启
到这里代理其实已经能用了,但还差关键一步——认证。只靠IP白名单不够灵活,一旦你的出口IP变化或有同事从别处连,就会连不上;而彻底放开又有被蹭的风险。所以下一步补上账号密码。
第三步:加认证,别让端口裸奔
Squid支持标准的账号密码认证,用htpasswd生成密码文件:
sudo apt install apache2-utils -y
sudo htpasswd -c /etc/squid/passwd user01

# 再加账号就去掉-c
sudo htpasswd /etc/squid/passwd user02
然后在 squid.conf 里加上认证配置:
auth_param basic program /usr/lib/squid/basic_ncsa_auth /etc/squid/passwd
auth_param basic realm Proxy Login
acl authenticated proxy_auth REQUIRED
http_access allow authenticated注意配置文件是顺序敏感的:http_access规则从上往下匹配,allow放前面、deny all放最后,写反了会出现"全都连不上"或"全都拦不住"两种极端。改完先跑 squid -k parse 检查语法再reload,能少踩一半的坑。
第四步:验证上线,跑通第一笔请求
先用curl做最小验证,返回的IP是你的服务器IP,就说明代理生效了:
curl -x http://user01:你的密码@服务器公网IP:3128 http://httpbin.org/ip再放进代码里跑,Python的requests三行接入:
import requests

proxies = {
    "http": "http://user01:你的密码@服务器公网IP:3128",
    "https": "http://user01:你的密码@服务器公网IP:3128",
}
resp = requests.get("http://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())
上线之后有三件日常维护的事别忘:
看日志。访问记录在 /var/log/squid/access.log,谁在用、用了多少、有没有异常请求,都在里面。日志会越滚越大,配一个logrotate规则按天切割。
盯资源。别凭感觉,装个netdata或者直接用云监控,重点看带宽和连接数,曲线突增往往意味着认证配置出了问题。
打补丁。每月固定跑一次 apt update && apt upgrade,代理软件的历史漏洞不少,这五分钟不能省。
自建之外:什么时候直接用现成代理IP服务更划算
把账算清楚就明白了。自建方案的所有成本,本质都是在为"一个固定出口"付费;而数据采集类任务往往需要不断获取新的IP——目标网站对单个IP的频率限制摆在那里,一个出口撑不起整个任务。这时候两条路线的差距很直观:
| 对比项 | 自建代理服务器 | 神龙HTTP代理服务 |
|---|---|---|
| IP数量 | 一台机器一个出口 | 3000万+正规授权IP储备 |
| 可用率 | 靠自己维护保障 | 可用率99.9%,IP纯度99.8% |
| 城市覆盖 | 买一台算一个地区 | 300+城市级精准定位 |
| 接入成本 | 半天到几天搭建调试 | API兼容主流爬虫语言,当天接入 |
| 后续维护 | 系统、补丁、日志全自己扛 | 技术团队7×24小时支持 |
拿神龙HTTP来说,最省心的是接入环节:拿到API后填进爬虫的代理参数就能跑,文档里连各语言的示例代码都准备好了,不用自己折腾环境。跑起来之后,后台还有可视化的用量统计和实时监控,消耗了多少、有没有异常请求,一眼看清——这恰好是自建方案里最费工夫的部分。
我的建议是两条腿走路:核心业务要一个长期稳定的自控出口,按上面的流程自建;需要大IP池支撑的采集任务,直接接现成服务,把时间花在业务逻辑上。

常见问题
Q: 自建一台代理服务器,一年大概花多少钱?
以2核4G按量计费的入门云主机估算,机器加少量流量每月几十元上下,一年几百元。真正的大头是流量:如果采集任务每天跑几十GB,按量流量费会明显上涨,这时候要重新算账,对比现成代理服务的按量套餐哪个更省。
Q: 代理搭好了,但速度很慢,从哪里排查?
按顺序查三处:一是带宽,代理服务器的出入流量都走它的带宽,按量计费的峰值带宽可能被压得很低;二是链路,分别测"你到代理服务器"和"代理服务器到目标网站"的延迟,确定慢在哪一段;三是DNS,在squid.conf里指定 dns_nameservers 223.5.5.5 这类公共解析,解析慢会拖累每个请求的首字节时间。
Q: 一定要用Squid吗?有没有更轻的选择?
有。TinyProxy配置只有几行,适合纯转发、不需要复杂规则的场景;3proxy更小巧,资源占用极低。但如果你需要认证、访问控制、日志审计这些完整能力,Squid仍是省心的选择,遇到问题能搜到的解决方案也最多。
Q: 自建的出口IP被目标网站限制了怎么办?
短期可以降低请求频率、补全请求头里的浏览器特征,很多限制是频率触发的。长期看,单靠一台服务器的固定出口,回旋余地确实有限——这也是现成代理IP服务的价值所在:需要时从IP池里获取新的IP,任务不中断。神龙HTTP的短效动态IP就是为这类高频采集场景准备的。