先从一个常见困扰说起
做过公开数据采集的人多半遇到过这种怪事:脚本明明拿到了新IP,跑不了几分钟还是被目标网站拦下来,甚至比不换的时候封得更快。排查半天,问题往往不在IP本身,而在你用的是哪种匿名等级的代理。很多便宜套餐给的是透明代理或普通匿名代理,真实IP和代理特征都写在请求头里,目标网站一眼就能看穿。这篇文章就把高匿代理这件事讲透:它的匿名原理是什么,和普通代理差在哪,哪些场景非用不可,以及怎么验证你买到的确实是真高匿。
代理IP的三个匿名等级,差别比想象中大
按匿名程度,代理IP通常分成三档:透明代理、普通匿名代理(也叫匿名代理)、高匿代理。划分标准只有一个——目标服务器能从你的请求里看到什么。
透明代理基本等于"裸奔"。它转发请求时会把你的真实IP原封不动塞进 X-Forwarded-For 字段,还会带上 Via 这类标识,服务器不但知道你的真实IP,还知道你挂了代理。普通匿名代理前进了一步,真实IP被藏住了,但请求头里仍留着代理的痕迹,服务器看不出你是谁,却知道你用了代理。高匿代理则是把两件事都做干净:真实IP不出现,代理特征也全部抹掉,在服务器眼里,这次请求和一台普通家用电脑直接发来的没有任何区别。
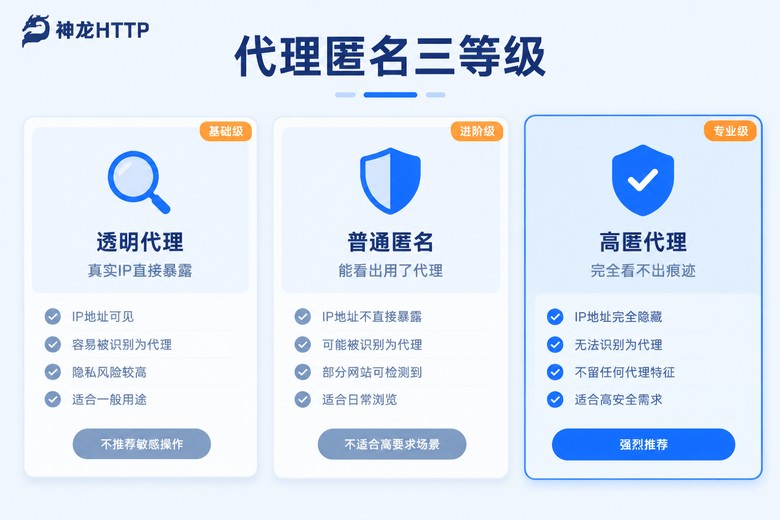
| 对比维度 | 透明代理 | 普通匿名 | 高匿代理 |
|---|---|---|---|
| 真实IP是否暴露 | 暴露 | 隐藏 | 隐藏 |
| 是否看得出用了代理 | 看得出 | 看得出 | 完全看不出 |
| 请求头特征 | 带真实IP和Via | 带Via等字段 | 无代理特征字段 |
| 适合场景 | 对匿名无要求的内部统计 | 匿名要求不高的轻量任务 | 数据采集、市场研究等正式业务 |
一句话总结:只要目标网站会检查请求头,高匿就是唯一靠谱的选择。前两种代理省下的钱,往往会在被封禁、返工重跑上加倍还回去。
高匿代理的"隐身"是怎么实现的
原理其实不玄乎。你访问任何网站,浏览器或脚本都会随请求附带一串请求头,比如 User-Agent、Accept-Language,而和代理相关的字段主要有三个:X-Forwarded-For(记录链路中的真实IP)、Via(记录经过的代理节点)、Proxy-Connection(代理连接标识)。
普通代理转发请求时基本照单全收,这些字段原样带到目标服务器。高匿代理在中间多做了两步处理:第一步,替换出口IP,目标服务器看到的来源地址是代理服务器的IP,你的真实IP从头到尾不出网;第二步,清理特征字段,把 X-Forwarded-For、Via 这些暴露身份的请求头改写或删掉,让请求看起来像一次普通的直接访问。
看一组对比就很直观:
# 透明代理到达目标服务器时
REMOTE_ADDR: 58.210.12.34        ← 代理服务器IP
X-Forwarded-For: 112.10.35.24    ← 你的真实IP,暴露了
Via: 1.1 proxy-node-03           ← 代理痕迹,暴露了

# 高匿代理到达目标服务器时
REMOTE_ADDR: 58.210.12.34        ← 只能看到代理服务器IP
(没有 X-Forwarded-For,没有 Via,干干净净)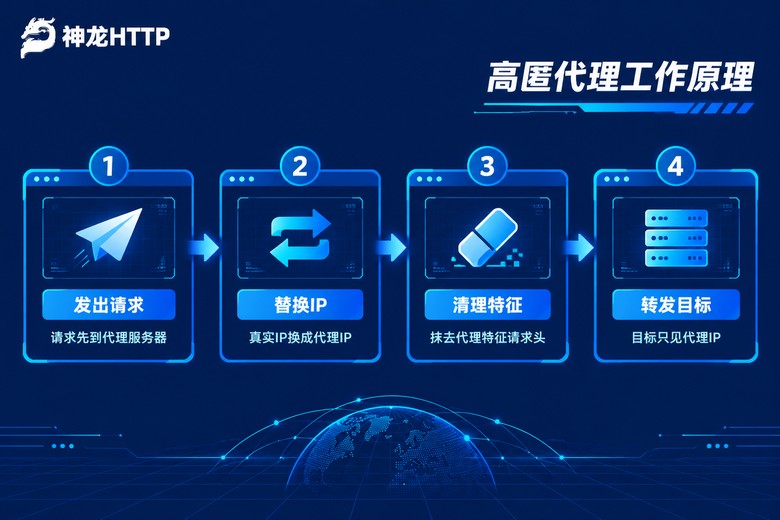
值得注意的是,匿名等级是"服务端行为",取决于代理服务器怎么处理请求头,跟你本地怎么配置关系不大。同一个客户端,挂透明代理和挂高匿代理,服务器看到的东西完全不同——这也是为什么买代理时必须确认匿名等级,而不是默认所有代理都一样。
哪些场景必须上高匿代理
不是所有任务都需要高匿,但下面这几类,匿名等级不够基本干不成:
公开数据采集。稍微有点规模的网站都有反爬机制,其中最基础的一条就是检查请求头。普通匿名代理带着 Via 字段来,等于敲门时自报"我是程序",很快就会被重点关照。高匿代理配合合理的请求频率,请求看起来和正常访客无异,采集任务才能长时间稳定跑下去。
市场研究与价格监测。这类任务的特点是周期长、访问频繁,可能连续几周每天定时抓取公开的商品信息和价格数据。目标平台对高频访问很敏感,匿名特征一旦暴露,轻则要求验证,重则直接限制访问,监测数据的连续性就断了。
AI大模型训练的数据准备。训练语料需要从大量公开网页获取,来源分散、总量大,请求量上来之后,匿名性不够的代理会让采集端很快被各个站点识别,数据获取效率大打折扣。
SEO与舆情监测。查询关键词排名、抓取公开的舆情信息,同样属于高频、重复的访问行为,用高匿代理能明显降低被识别的概率,保证监测结果稳定产出。
反过来说,如果只是内网统计、日志分析这类目标服务器本来就知道你是谁的场合,普通代理甚至透明代理就够了,没必要多花钱。
三步验证:你拿到的是不是真高匿
市面上标着"高匿"的代理不少,实际质量参差不齐。验证方法很简单:挂上代理去请求一个能回显请求头的测试接口,看返回结果里有没有代理特征字段。
以 Python 为例:
import requests

# 从服务商后台提取到的代理信息
proxy_host = "你的代理IP"
proxy_port = "端口"
proxies = {
    "http": f"http://{proxy_host}:{proxy_port}",
    "https": f"http://{proxy_host}:{proxy_port}"
}

# 请求任意一个能返回请求头信息的回显接口
resp = requests.get("回显测试接口地址", proxies=proxies, timeout=10)
print(resp.text)
拿到返回结果后,对照三条标准判断:
{
  "headers": {
    "User-Agent": "python-requests/2.31",
    "Accept": "*/*"
  },
  "origin": "58.210.xx.xx"
}
一看 origin:显示的应该是代理服务器的IP,而不是你的本机IP;二看有没有 X-Forwarded-For:出现这个字段并带着陌生IP,说明匿名处理不到位;三看有没有 Via、Proxy-Connection:这几个字段只要出现一个,都算不上严格意义的高匿。三条全过,才是真高匿。
挑高匿代理服务商,重点看这几项
确认了匿名等级,接下来就是选服务商。根据实际使用经验,这几个指标比价格更值得关注:
IP纯度。纯度低的IP被大量用户用过、在目标网站那里早有"前科",哪怕匿名等级够高也容易触发风控。像神龙HTTP公开标称IP纯度99.8%,这类指标可以直接拿来对比。
可用率与稳定性。采集任务最怕跑一半IP失效。可用率99.9%意味着提取一百个IP几乎个个能用,配合低延迟高并发提取,任务中断的概率会小很多。
协议与接入方式。至少要支持 HTTP/HTTPS/SOCKS5 三种协议,API要能兼容你用的编程语言。神龙HTTP提供文档和示例代码,主流爬虫框架接进去基本是改几行配置的事,遇到问题还有技术团队7×24小时响应。
来源是否正规。IP资源来路不明的服务商,用起来风险不小。神龙HTTP的3000万+代理IP来自国内三大运营商正规授权,覆盖300+城市级精准定位,需要指定地区的IP时也方便。
另外提一个实用细节:神龙HTTP的个人中心里有可视化用量统计和实时监控,哪个时间段消耗异常、成功率有没有波动,后台一眼就能看出来,排查问题不用全靠猜。
常见问题
Q: 高匿代理比普通代理贵不少,值得多花这个钱吗?
看目标网站的态度。如果目标站点不检查代理特征,普通匿名代理确实够用;但只要对方有基础的风控,普通代理很快就会被识别,任务反复中断、返工的时间成本远超差价。正经跑采集和研究类业务,建议直接上高匿。
Q: 用了高匿代理,是不是就绝对不会被识别?
不是。高匿解决的是请求头层面的暴露问题,但如果请求频率过高、访问规律太机械、User-Agent 千篇一律,依然可能被行为分析盯上。高匿要配合合理的采集策略才能发挥最大效果。
Q: 高匿代理的IP能用多久?失效了怎么办?
取决于产品类型。短效动态IP生命周期只有几分钟到几十分钟,适合需要频繁获取新IP的场景;长效静态IP可以稳定使用较长时间。IP失效属于正常现象,正规服务商的提取API可以随时获取新的IP,写进脚本里自动替换即可。
Q: 怎么判断服务商的IP是不是正规来源?
可以直接问对方资源的授权情况。正规服务商敢明确说IP来自运营商授权,比如神龙HTTP就是国内三大运营商正规授权,千万级代理IP资源可查可验。来路含糊、只强调便宜的服务商,建议谨慎。