上个月有个做电商价格监测的朋友找我吐槽:他的采集脚本每隔五分钟准时换一次IP,规则定得整整齐齐,结果目标网站的请求成功率还是一路往下掉。他以为是自己换得不够勤,把间隔缩到两分钟,情况反而更糟。
后来一起翻日志才发现,问题不在"换得多勤",而在"换得对不对"——他那批IP里有一小段本身质量就不行,换十次也还是那几个烂IP在轮。这件事让我觉得有必要把"动态代理IP多久换一次"掰开讲清楚,尤其是2026年这个时间点,不少老经验已经不太够用了。
先搞清楚:动态代理的"换",换的到底是什么
很多人对动态代理的理解停留在"IP会自己变"。更准确的说法是:你从一个IP池里取IP来用,每个IP有自己的有效期,到期失效,你再取下一个。所谓"更换",其实分两种情况。
一种是被动更换——IP到期了、被目标站限制了,不得不换;另一种是主动更换——IP还好好的,但你判断继续用下去风险变高,提前换掉。这两种换法的效果天差地别:被动更换是"坏了才修",请求已经失败了才行动;主动更换是"定期保养",在出问题之前就降低单个IP的使用强度。2026年比较成熟的做法,是尽量把被动更换压缩到最少,让主动更换成为常态。
还有一个容易被忽略的点:动态代理的"动态"程度,其实在你选产品的时候就定下来了。短效动态IP的有效期可能只有几分钟,长一点的也就二十来分钟;而长效静态IP能稳定用很久。所以"多久换一次"这个问题,一半取决于业务,另一半取决于你选的产品类型。
2026年场景对照:不同业务该按什么节奏换
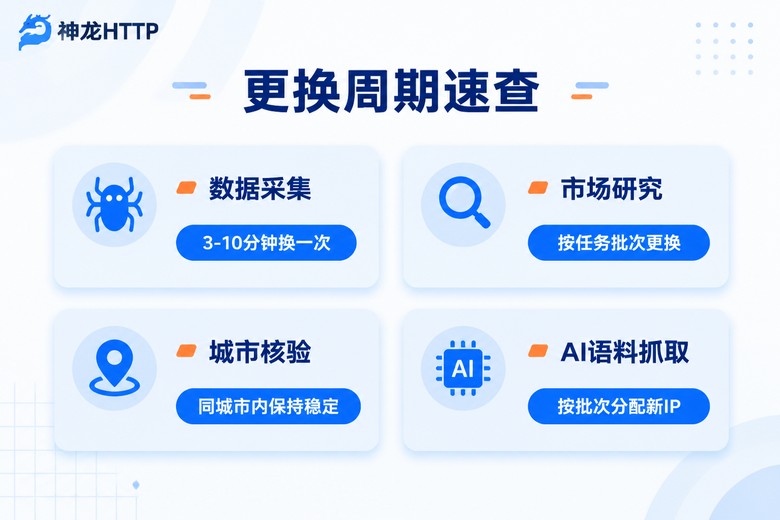
下面这张表是我根据近几年项目经验整理的,覆盖了最常见的几类场景。先说明一点:这些数字是起点参考值,不是标准答案,具体要结合目标网站的实际情况去调。
| 业务场景 | 建议更换节奏 | 背后的逻辑 |
|---|---|---|
| 公开网页采集 | 每个IP用3~10分钟,或每50~200个请求 | 单IP使用强度低,不容易触发限制 |
| 价格监测、市场研究 | 按任务批次换,一轮任务一个IP | 同一轮数据来源一致,方便核对 |
| 指定城市的核验类任务 | 换个地区的IP时整批换,同城内保持稳定 | 城市跳来跳去反而显得不自然 |
| AI大模型语料抓取 | 按批次分配,重质不重量 | 任务跑得久,IP质量比数量重要 |
| 长周期观察类任务 | 尽量少换,直接用长效静态IP | 中途换IP会导致观测数据前后不一致 |
两点补充。第一,"每50~200个请求"这个区间要看目标站的容忍度:有的站点对单IP请求频率卡得很死,可能50个就到顶了;有的松一些,跑几百个也没事。上线前先用小流量试跑半小时,看成功率曲线从哪里开始往下走,那个点就是你的安全线。第二,如果怎么调周期成功率都上不去,问题大概率不在周期上,而在IP池本身的质量——这个后面细说。
定时换、按量换、按效果换:三种策略怎么选
定更换节奏,常用的思路有三种,复杂度和效果递增。
策略一:定时轮换。每隔N分钟强制取新IP。优点是逻辑清晰、实现简单;缺点是粗放——任务闲的时候白白浪费IP有效期,任务忙的时候又可能换得太慢。适合对成功率要求不高的轻量任务。
策略二:按请求量轮换。每跑够N个请求就换。比定时更贴合实际负载,因为采集强度直接对应请求量。缺点是没考虑IP自身的健康状况——一个已经开始被限制的IP,跑不满N个请求就废了,你还在按计划用它。
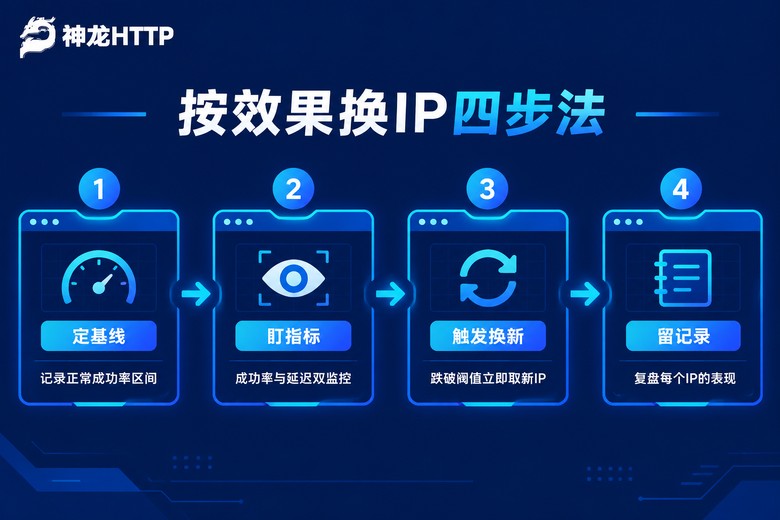
策略三:按质量信号轮换(推荐)。不预设固定周期,而是实时盯着几个关键指标:请求成功率、响应延迟、异常页面出现的频率。任何一个指标越过警戒线,立刻获取新的IP,同时给这个IP记上一笔。这是2026年比较主流的做法,本质是让数据告诉你什么时候该换,而不是拍脑袋定时间。
实际项目里,我一般建议组合着用:以按请求量轮换做骨架(比如每100个请求保底换一次),再叠加质量信号做提前更换。这样既有下限保障,又有灵活调整的空间。
动手实现:给采集脚本装一个"会自己判断"的IP管理器
光讲概念不落地等于没讲。下面这段Python代码是一个极简的IP管理器,思路就是策略三:给每个IP记成功率,跌破阈值就取新的。
import time
import requests

class IpPoolManager:
    def __init__(self, api_url, min_success_rate=0.9, max_requests=100):
        self.api_url = api_url          # 供应商的提取接口
        self.min_success_rate = min_success_rate
        self.max_requests = max_requests
        self.current_ip = None
        self.stats = {"total": 0, "ok": 0}

    def fetch_new_ip(self):
        """从IP池获取一个新的IP"""
        resp = requests.get(self.api_url, timeout=10).json()
        self.current_ip = resp["ip"] + ":" + str(resp["port"])
        self.stats = {"total": 0, "ok": 0}   # 新IP重新计数
        print(f"[{time.strftime('%H:%M:%S')}] 已获取新IP: {self.current_ip}")

    def should_rotate(self):
        """请求数达标 或 成功率跌破阈值 时更换"""
        if self.current_ip is None:
            return True
        if self.stats["total"] >= self.max_requests:
            return True
        if self.stats["total"] >= 10:  # 至少跑10个再评估,避免误判
            rate = self.stats["ok"] / self.stats["total"]
            if rate < self.min_success_rate:
                return True
        return False

    def get(self, url):
        if self.should_rotate():
            self.fetch_new_ip()
            time.sleep(1)  # 给新IP一个缓冲
        proxies = {"http": f"http://{self.current_ip}",
                   "https": f"http://{self.current_ip}"}
        try:
            r = requests.get(url, proxies=proxies, timeout=15)
            self.stats["total"] += 1
            if r.status_code == 200:
                self.stats["ok"] += 1
                return r
        except Exception:
            self.stats["total"] += 1
        return None

# 用法示例
manager = IpPoolManager(api_url="你的提取链接",
                        min_success_rate=0.9, max_requests=100)
for page in range(1, 501):
    resp = manager.get(f"https://example.com/list?page={page}")
    if resp is None:
        print(f"第{page}页请求失败,稍后重试")
几十行代码,但三件事都覆盖了:保底轮换(max_requests)、质量触发(min_success_rate)、新IP缓冲。可以直接塞进现有项目,再把阈值按实际表现调。
有个细节值得单独说:评估成功率时我设了"至少跑10个请求"的门槛。刚取到一个IP,第一个请求恰好碰上目标站抖动,就判定它不行,会造成大量无意义的更换。给每个IP一点证明自己的机会,整体效率反而更高。
比更换周期更值得花心思的三件事
这几年做下来,我越来越觉得"更换周期"只是表层问题,下面三件事才是决定成败的关键。
第一,IP的"履历"比更换频率更重要。现在主流网站的风控早就不只看频率了,它们会看这个IP历史上都干过什么。一个被大量低质量任务用过的IP,哪怕你刚拿到手、一次请求都没发,也可能一上来就被重点照顾。这就是为什么有些人换了IP情况也没好转——新IP本身就是"脏"的。
第二,IP纯度成了硬指标。纯度粗略理解就是这个IP有多少人在同时用、用它的都是什么业务。纯度高的IP接近独享,行为干净;纯度低的IP,前面无数人留下的痕迹都在拖累你。选服务商时这个指标比"IP数量"更值得看。像神龙HTTP公布的IP纯度是99.8%,配合国内三大运营商的正规授权,拿到的IP底子干净,更换起来才有意义——池子干净,换新才是真换新;池子脏,换新只是换个姿势踩坑。
第三,池子的规模和更新速度决定上限。池子太小,翻来覆去就那几个IP,换得再勤也逃不出循环;池子更新慢,失效IP清理不及时,你取到的"新"IP可能早就被用废了。神龙HTTP有3000万以上的正规授权代理IP储备,覆盖300多个城市,做大规模采集时这种池子深度的差距非常明显——同样的更换策略,池子深的那个成功率曲线就是更平。
这些坑,踩过的人才知道疼
坑一:会话中途换IP。有些业务需要维持状态,比如登录后的连续操作,中途更换等于告诉对方"这不是同一个人了"。这类请求要单独处理,绑定固定IP跑完整个会话,别混进轮换逻辑里。
坑二:只换IP,不换请求特征。IP换了,但请求头、访问间隔、点击路径一模一样,风控照样能认出来。更换IP要和请求特征的随机化配合着做,两件事缺一不可。
坑三:失败后立刻疯狂重试。请求一失败就连发好几次,等于在IP已经很脆弱的时候继续加压。正确做法是指数退避:第一次等2秒,第二次等4秒,还失败就直接取新IP。
坑四:把"换得勤"当万能药。回到开头那位朋友——间隔从5分钟缩到2分钟,成功率反而更低。因为更换本身有成本:取IP、建连接、预热,每次都是开销。换得对,永远比换得勤重要。
常见问题
Q:动态代理IP是不是更换得越频繁越好?
不是。换得太勤有两个代价:一是每次更换都有取IP和建连接的开销,拖慢整体速度;二是短时间内IP跳来跳去,在部分风控模型里反而是可疑特征。合理的做法是以业务负载和质量信号为准,该换才换。
Q:短效动态IP和长效静态IP,到底怎么选?
看任务需不需要"连续性"。跑得快、量大的采集任务,短效动态IP更划算,用完即弃;需要保持状态、长时间观测的任务,长效静态IP更稳。很多团队是两种搭配着用,不同模块走不同的产品线。
Q:怎么判断当前这个IP该换了?
盯三个信号:请求成功率跌破你设的阈值(比如90%)、响应延迟明显变长、返回内容里开始出现异常页面。任何一个出现,都说明这个IP的风险在升高,别等它彻底失效,主动更换的成本最低。
Q:刚换的新IP表现也很差,是什么原因?
大概率是IP池本身的质量问题,而不是你的策略问题。池子里失效IP清理不及时、低质量IP占比高,换多少次都一样。这种情况建议换一家池子更大、更新更及时的服务商试试,比如神龙HTTP这种有正规授权、可用率99.9%的,先排除供给侧的因素,再去调自己的代码。