先说个真事。朋友在济南做本地生活信息的聚合展示,脚本部署在外地机房,抓山东本地某分类信息平台的公开数据,三天两头被限流,拿回来的内容还总缺一截——同一批房源,济南本地用户能看到完整的小区名和门牌,他从外地访问只能拿到概要。后来给脚本配上济南本地的代理IP,同样的代码,一次没再断过。
这件事说明一个朴素的道理:做本地化业务,节点在哪,结果就差在哪。这篇就把济南代理IP的获取路子、本地节点的实际用法、拿到手怎么验货,一次性讲透。
什么活儿需要济南本地的IP
不是所有业务都对节点位置敏感,但下面这几种,本地节点带来的收益非常直接。
公开数据的地区版本差异。很多平台会按访问者所在城市返回不同内容:价格、库存、活动页甚至排序都不一样。想拿济南用户看到的那一版,就得从济南的出口去请求,否则采回来的数据天生就偏。
延迟和链路质量。济南到山东省内目标服务器的物理距离短,往返延迟普遍能压得很低,长跑任务不容易超时。跨省绕一圈,抖动和丢包都会明显上来。
访问节奏的自然度。用本地IP按正常频率访问本地站点,链路特征和真实用户更接近,任务跑起来更平稳,不容易触发目标站点的频率防护。
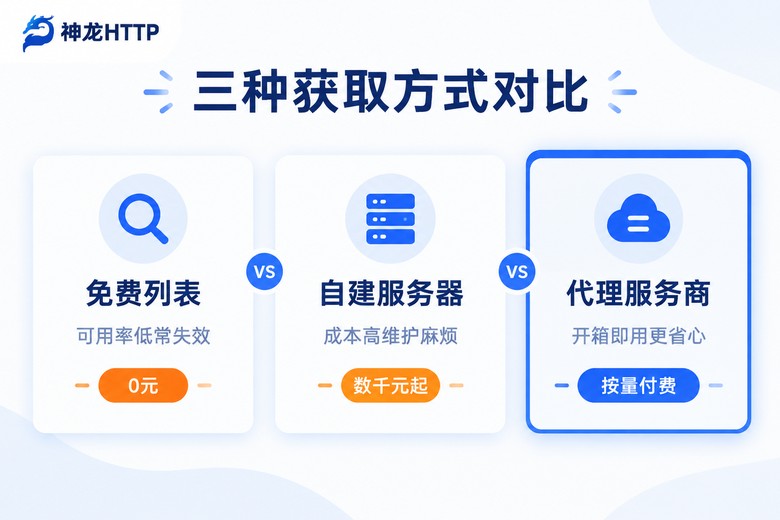
三条获取路子,账要分开算
想拿到济南的代理IP,市面上就三条路,成本结构完全不同,适合的人也不一样。
路子一:免费代理列表。网上能搜到不少公开的IP列表,里面偶尔混着济南节点。零成本是真的,可用率惨也是真的——我实测过一批,二十个里能连通的不到两个,存活时间还以分钟计。拿来学习原理、跑通流程可以,正经业务别指望。
路子二:自建拨号服务器。在济南本地放一台拨号设备或者租本地宽带,自己搭代理服务。好处是可控,坏处是硬件加宽带的前期投入不小,断线重连、IP池维护都得有人盯着。适合长期只跑济南一个城市、预算充足的大户。
路子三:专业代理服务商。这是绝大多数团队的选择。以神龙HTTP为例,3000万+正规授权代理IP储备覆盖300+城市,济南这类省会城市属于标配节点;国内三大运营商正规授权,支持HTTP/HTTPS/SOCKS5三种协议。在后台选好城市,通过API提取链接就能按需拉取节点,不用自己养IP。
| 获取方式 | 前期成本 | 稳定性 | 维护投入 | 适合谁 |
|---|---|---|---|---|
| 免费列表 | 0元 | 极不稳定 | 要写大量验证逻辑 | 学习试水 |
| 自建拨号 | 数千元起步 | 取决于线路 | 需专人值守 | 单城市长期大户 |
| 专业服务商 | 按量付费 | 可用率99.9% | API接入即可 | 绝大多数业务团队 |
济南节点真正能派上用场的场景
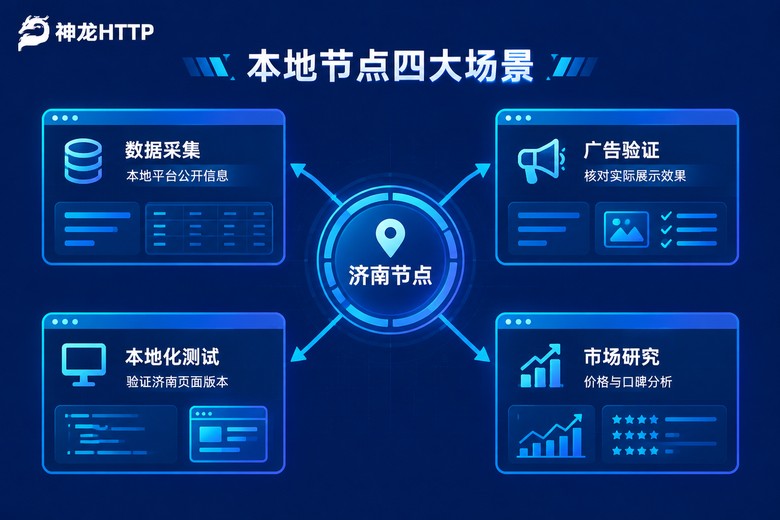
本地生活与分类信息的公开数据采集。房源、招聘、二手转让、本地活动这类信息,地域属性极强。用济南节点去取,拿到的就是济南用户实际看到的内容,字段完整度和外地出口完全是两个量级。
广告与投放效果验证。投放了山东区域的推广,想知道济南本地用户实际看到什么广告位、什么搜索排名,用本地节点访问一遍核对展示结果,比只看平台后台报表更直接。
本地化产品测试。App或网站做了分城市的内容策略,上线前用济南节点把核心页面过一遍,验证文案、活动入口、加载表现是否符合预期,能提前拦下不少问题。
市场研究与价格监测。山东本地商超、连锁品牌的价格和促销信息是市场研究的重要原料。济南节点配合定时任务,可以持续跟踪本地价格带的变化,形成自己的数据积累。
AI训练数据的地域补充。大模型训练需要覆盖不同地域的公开语料,济南及山东本地的公开文本、页面结构数据,能帮模型补上区域特征的短板。神龙HTTP的低延迟高并发提取,正是为这类大规模采集需求设计的。
拿到手先验货:四项体检
不管从哪个渠道拿到的济南节点,正式跑业务前建议先做四项检查。花十分钟,省后面十小时的排查。
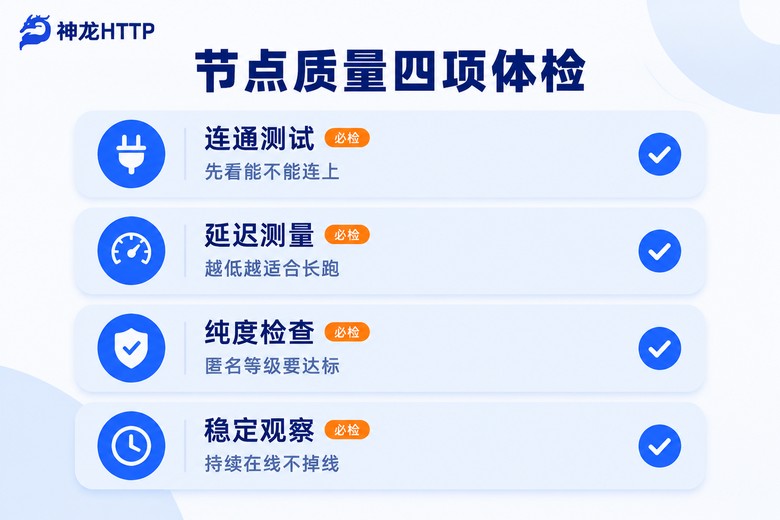
第一项,连通测试。先确认节点能不能正常建立连接,把明显不通的筛掉,别让坏节点混进任务队列。
第二项,延迟测量。连上之后测往返耗时,济南本地目标建议压在几十毫秒以内,超出太多的节点跑长任务容易超时。
第三项,纯度检查。看请求头里有没有暴露代理特征,匿名等级不达标的节点,拿回来的数据容易被区别对待。
第四项,稳定观察。让节点持续跑半小时以上,看会不会中途掉线。神龙HTTP的个人中心里有可视化用量统计和实时监控,异常节点能直接识别出来,使用趋势也有图表可查,不用自己写脚本盯。
下面这段Python代码,是接入和验货的最小示例:
import requests
import time

# 从神龙HTTP后台生成API提取链接,请求后即可拿到济南节点列表
proxy_ip = "提取结果里的IP"
proxy_port = "对应的端口"

proxies = {
    "http": f"http://{proxy_ip}:{proxy_port}",
    "https": f"http://{proxy_ip}:{proxy_port}",
}

TARGET_URL = "https://你的目标站点域名"  # 替换成实际的采集地址

start = time.time()
resp = requests.get(TARGET_URL, proxies=proxies, timeout=10)
cost = (time.time() - start) * 1000

print("状态码:", resp.status_code)
print(f"往返耗时: {cost:.0f} 毫秒")
跑通这一步,再把它套进业务代码就行。神龙HTTP的API兼容主流爬虫编程语言,文档和示例代码都是现成的,接入基本不费事;遇到问题,技术团队7×24小时在线,不用自己硬扛。
常见问题
Q: 济南代理IP一个能用多久?
看产品类型。短效动态IP的生命周期从几分钟到几十分钟不等,适合需要频繁获取新IP的采集任务;长效静态IP可以按天保持不变,适合有会话保持需求的业务。神龙HTTP的短效动态、长效静态、固定IP代理三条产品线分别对应不同周期,按业务节奏选就行。
Q: 免费的济南代理能不能凑合用?
学习、测试可以,生产环境不建议。免费节点可用率低、延迟高、来源不明,一旦在关键任务里掉链子,排查花费的时间远超省下的那点成本。
Q: 一个济南IP不够用怎么办?
通过API提取接口按需拉取就行,配合失败重试逻辑。神龙HTTP支持高并发提取,如果济南节点紧张,还可以就近补充淄博、泰安等山东周边城市的节点,链路质量同样有保障。
Q: 怎么确认拿到的IP真的落在济南?
两步走:先请求回显出口IP的接口,看实际出口地址是多少,再查这个IP的归属地信息;更直接的办法是对比同一页面在济南出口和外地出口下返回内容的差异,有地区版本差异的站点,一眼就能看出来。