跑采集的朋友对这一幕肯定不陌生:脚本前几分钟还顺顺利利,突然开始整页报错,日志里 timeout 刷屏,换个IP好了两分钟,接着又挂。很多人第一反应是"代理不行",急着去找服务商理论。先别急,连接失败的原因有一大半根本不在代理身上,而是出在你自己的代码、本地环境,或者目标网站的风控策略上。
这篇文章就带你把失败原因一层层剥开:从最容易忽略的本地问题查起,一路查到代理质量和目标网站,每一步都给你能直接上手的操作。
先分清:你的"失败"到底是哪一种
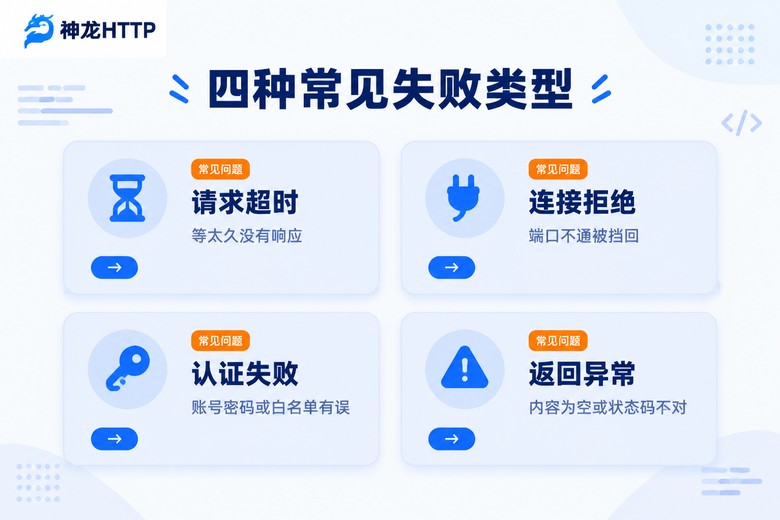
"连接失败"其实是个笼统说法,报错信息不同,背后的原因天差地别。动手排查之前,先把日志翻出来,看看你遇到的是下面哪一种。
| 错误现象 | 大概率原因 | 第一步做什么 |
|---|---|---|
| 请求超时(Timeout) | IP已失效、线路拥堵 | 换个IP立刻重试 |
| Connection refused | 端口写错、代理下线 | 核对IP、端口、协议 |
| 407 认证错误 | 密码错、白名单没加 | 检查账号密码和白名单 |
| 返回空内容或4xx/5xx | 被目标站限流拦截 | 降频率、补请求头 |
举个例子:看到的是 ProxyError 或 Connection refused,八成是代理地址、端口写错了,或者这个IP已经下线;如果是超时,那可能是IP失效,也可能是你本地网络本身就不通畅。错误类型对上了,排查方向就清晰了,不至于像无头苍蝇一样乱试。
第一层排查:本地环境,一半的锅其实是自己的
我见过太多人一失败就骂代理,结果查了半天,是自己代码里少写了一个键。按下面的顺序过一遍,能筛掉大部分低级问题。
1. 先绕开代理直连一次。在命令行里直接请求目标网站,如果不通,那是你本地网络或者目标站的问题,跟代理没关系:
curl -I https://目标网站.com
# 返回 HTTP/2 200 说明本地直连没问题,继续往下查代理
2. 检查代理配置写法。用 Python requests 的朋友注意,proxies 字典里 http 和 https 两个键都要写,漏一个就会出现"有的请求能通、有的全挂"的诡异现象:
import requests

proxies = {
    "http": "http://用户名:密码@代理地址:端口",
    "https": "http://用户名:密码@代理地址:端口"  # 这个键经常被漏掉
}

resp = requests.get("https://目标网站.com",
                    proxies=proxies,
                    timeout=(5, 10))  # 连接5秒、读取10秒,一定要设
print(resp.status_code)
3. 看看环境变量有没有捣乱。有些人在系统里设过 http_proxy 环境变量,后来忘了,结果代码里配的代理和系统变量打架,请求走了两条完全不同的路。Windows 下用 set http_proxy 查,Mac 和 Linux 用 env | grep -i proxy 查,有残留就清掉。
4. 防火墙和杀毒软件。部分安全软件会拦截非常用端口的对外连接,尤其是代理端口开在 8000 以上的时候。临时关掉防火墙再测一次,如果立刻就通了,把代理端口加进白名单即可。
第二层排查:代理本身,IP是会过期的
本地没问题还失败,那就要审一审代理了。这里有几个高频踩坑点,个个都让不少人栽过跟头。
短效动态IP寿命有限。很多人不理解这一点,拿到一批IP就全部塞进池子里,跑到一半大面积超时——其实是IP到期失效了。正确的做法是用之前先验活,失效的及时从池子里剔掉:
def check_ip(ip, port):
    """快速验活:3秒内能通才算可用"""
    try:
        requests.get("https://www.baidu.com",
                     proxies={"http": f"http://{ip}:{port}"},
                     timeout=3)
        return True
    except requests.exceptions.RequestException:
return False协议别用混了。服务商给你的是 SOCKS5 代理,你却按 HTTP 的方式去连,必然失败。拿到代理先确认协议类型;另外 requests 里走 SOCKS5 还需要额外装一个 PySocks 依赖,忘了装就会报 Missing dependencies 错误,很多人卡在这里还以为是代理坏了。
并发别开太猛。一个IP同时挂几百个请求,对方服务器直接把你晾在那儿。合理的做法是单个IP控制在几到十几个并发,并且失败后自动取新IP重试,而不是死磕同一个:
import time

def fetch_with_retry(url, ip_pool, max_retry=3):
    for i in range(max_retry):
        ip = ip_pool.get_ip()  # 每次重试都取一个新IP
        try:
            resp = requests.get(url,
                                proxies={"http": f"http://{ip}",
                                         "https": f"http://{ip}"},
                                timeout=(5, 10),
                                headers={"User-Agent": "Mozilla/5.0"})
            if resp.status_code == 200:
                return resp.text
        except requests.exceptions.RequestException:
            pass
        time.sleep(2 * (i + 1))  # 间隔递增,别连续猛试
    return None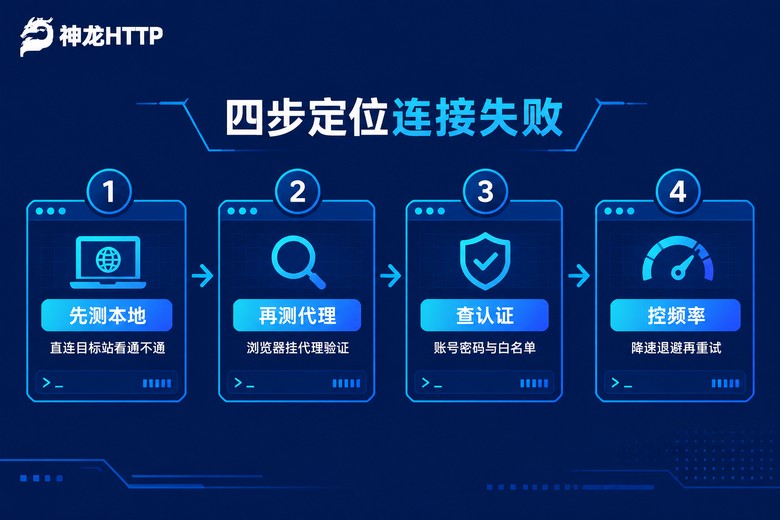
第三层排查:目标网站在拦你
如果代理验活通过、本地也没问题,浏览器挂上代理能正常打开网页,一上脚本就失败——那大概率是目标网站的风控在起作用。几个典型的信号和对应的处理办法:
请求头太裸。requests 默认的 User-Agent 一眼就能被认出来,补上正常的浏览器请求头,成功率会明显提升。除了 User-Agent,Referer、Accept 这些字段也建议一并带上,让请求看起来更像真人操作。
频率太高触发限流。同一个IP每秒打几十个请求,换谁都会拦。给请求之间加随机间隔,比如 1 到 3 秒不等,别用固定值——固定间隔本身也是一种容易被识别的规律。
失败后要退避,不要硬刚。连续失败时把等待时间逐次拉长(2秒、4秒、8秒),同时换个新IP再试。硬刚只会让手头的IP死得更快,还会连累同池子里其他IP的信誉。
从源头减少失败:代理质量决定排查成本
排查技巧再熟练,也不如一开始就用上质量过硬的代理。判断一家服务商靠不靠谱,重点看硬指标——可用率。
以神龙HTTP为例,它手握3000万以上正规授权代理IP储备,全部来自国内三大运营商的正规授权,可用率达到99.9%。落到实际使用里,就是你抽出来的IP绝大多数是活的,验活和重试消耗的精力能省下一大截,脚本也不会动不动就整批报错。
另一个容易被忽略的价值在出问题之后。神龙HTTP的个人中心提供可视化用量统计和实时监控,成功率一有异常波动马上就能看出来,帮你快速分清是IP的问题还是自己代码的问题;技术团队7×24小时在线,排查不动的问题直接找人,比自己闷头试错快得多。
常见问题
Q:代理在浏览器里能打开网页,一到脚本里就失败,怎么回事?
大概率是代码配置问题。重点检查三处:proxies 字典是否把 http 和 https 两个键都写了;认证信息格式是否正确(用户名:密码@地址:端口);有没有设置 timeout。浏览器能通说明代理本身没问题,问题九成出在请求写法上。
Q:超时时间设多少比较合适?
建议把连接超时和读取超时分开设,比如 timeout=(5, 10):连接5秒足够判断IP死活,读取10秒给目标站留出响应时间。设太短会把慢一点的正常请求误判为失败,设太长又会让失败请求拖垮整个任务的节奏。
Q:请求失败后应该立刻换IP重试吗?
不建议零间隔硬试。正确姿势是:失败后先等1到2秒,取一个新IP再试,连续失败就把间隔逐次拉长。如果换了好几个IP都在同一个页面失败,那问题多半不在IP,回头检查请求头和请求频率。
Q:为什么免费代理的失败率特别高?
免费代理来源杂、没人维护,IP失效速度极快,还经常很多人同时挤同一个IP,可用率能到一半就不错了。如果是正经业务场景,时间成本远超代理费用,直接用神龙HTTP这类正规授权的付费服务,99.9%的可用率加上7×24小时技术支持,整体排查成本反而更低。