数据中台这类系统有个特点:架子搭得挺快,脏活全在后面。外部数据源一个个接进来,任务数从十几路涨到上百路,出口就那一个,问题也就来了——某一路任务把IP跑进了目标站点的黑名单,别的任务跟着一起挂;业务方来问昨天的价格数据为什么缺了一大块,你把网关日志翻到底,也只看到一堆时间戳,不知道是哪个项目、哪个任务、哪个IP出的问题。
这篇不讲架构图,就讲三件很实在的事:谁能用代理、能用多少、用完留下什么痕迹。做完这三件,出口这一层基本就安静了。
一、先回答"谁在用":数据中台里的权限分层
最常见的坏做法,是全公司共用一个提取凭证,谁要IP就去拉一把。省事是真的省事,但出问题时没人认账。你把凭证丢给五个项目组,等于默认接受了"任何一路任务都可能背锅"。
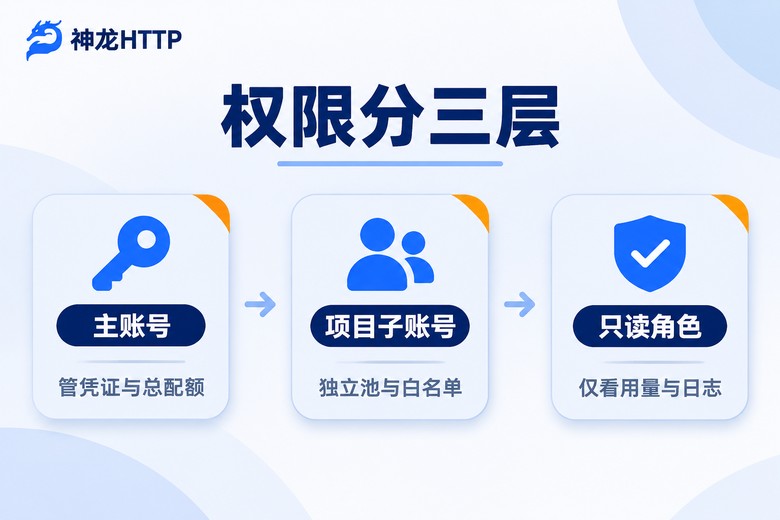
比较稳的分法是把凭证和IP池绑在一起,做三层:
最上面是主账号,只给平台运维握着。它的作用是管总额度、开子账号、看全局用量,日常不拿它跑任务。
中间是项目子账号,一支采集任务对应一个。关键在于每个子账号绑独立的IP池或独立的白名单——出口机器的内网IP先登记进去,别人就算拿到凭证也用不了,这一招挡掉大部分凭证外泄的风险。
最下面是只读角色,给业务方和技术负责人看用量和失败记录用的,能看不能提,避免"顺手测一下"把生产池子跑脏。
落到表上大概长这样,数值是示意,你按自己的体量改:
| 角色 | 拿到的凭证 | IP池范围 | 日提取上限 | 可见范围 |
|---|---|---|---|---|
| 平台运维 | 主账号 | 全部池 | 不设 | 全局 |
| 数据开发 | 项目子账号 | 短效动态池 | 50 万次 | 本项目 |
| 算法训练 | 项目子账号 | 长效静态池 | 20 万次 | 本项目 |
| 外部项目组 | 临时子账号 | 独立小池 | 5 万次 | 仅失败记录 |
另外提醒一句:短效动态、长效静态、固定IP这三类池子,不要混在一个子账号里提。用途完全不同,混着提,出问题时你连用的是哪一类都分不清。
二、并发不是越大越好,是三个旋钮一起拧
很多人第一次做并发,思路是"线程数拉满"。跑到半夜接口开始大面积超时,还以为是代理不行。实际上大部分时候是三个参数没配合好。
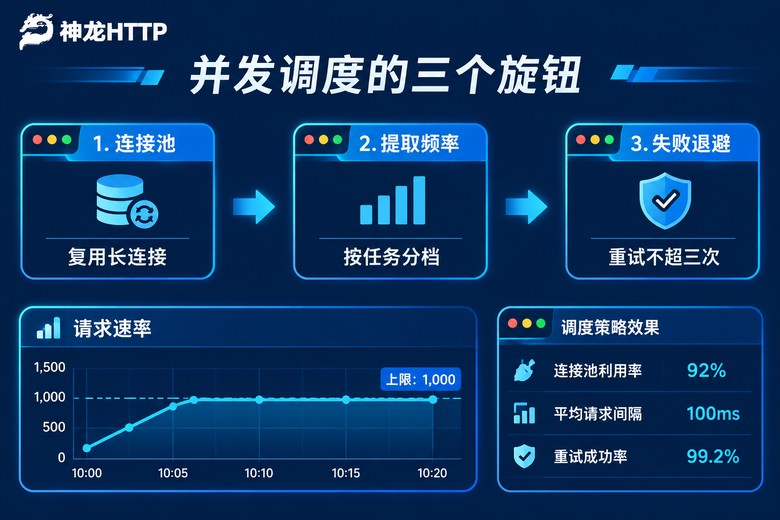
连接池。Python 的 requests 默认连接池很小,你开 200 个线程,实际复用效率很差。要先把它放大,再谈并发数。连接池的上限决定了你能真正同时打开多少条通道。
import time, requests
from requests.adapters import HTTPAdapter

sess = requests.Session()
# 连接池放大到 200,避免高并发下反复建连
sess.mount("https://", HTTPAdapter(pool_connections=50, pool_maxsize=200))

def fetch(url, proxy, retry=3):
    for i in range(retry):
        try:
            r = sess.get(url,
                         proxies={"http": proxy, "https": proxy},
                         timeout=8)
            if r.status_code == 200:
                return r.text
        except requests.RequestException:
            pass
        time.sleep(1.5 ** i)   # 退避重试,别原地猛撞
    return None
提取频率。IP池是有容量概念的。峰值并发 200、每 60 秒换一批,意味着池子至少要在 1:5 以上的余量备着,才不会出现"提不到IP"的尴尬。做法是按任务分档:日更型任务低频提取、小时级任务中频、分钟级任务才用高频档,别所有任务都堆在同一个档位上。
失败退避。这条最容易被忽略。目标站点偶尔返回 5xx,代码原地重试五次,等于同一个IP连撞五次墙,IP不封你封谁。把重试次数卡在 3 次、间隔用指数退避(1.5 秒、2.25 秒、3.4 秒),失败率能明显压下来。
举个实际量级:一个日更 200 万条商品数据的任务,峰值 200 并发,配 1000 条左右的动态池,用上面这套参数跑,稳定期失败率大概能压在 1% ~ 3% 之间。如果失败率长期在 10% 以上,先别怀疑供应商,回去检查连接池和退避写对没有。
三、调用审计:日志字段决定你能查多深
审计这块,不用搞得很复杂,但字段一定要在写代码的时候就落下去。我见过太多项目,出事了才开始加日志,然后再等一周数据积累,黄花菜都凉了。
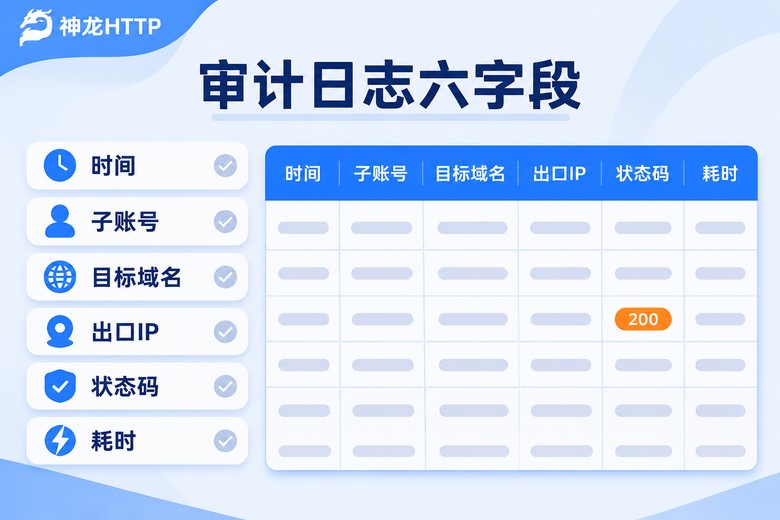
一次代理调用,最少留这六个:
{
  "ts": "2024-06-11T10:23:07+08:00",
  "sub_account": "proj-price-02",
  "target": "<目标域名>",
  "egress_ip": "<本次使用的出口IP>",
  "status": 200,
  "cost_ms": 412,
  "retry": 0
}
六个字段有了,能回答的问题就多了:某个项目今天跑了多少、哪一路失败率最高、某个出口IP是不是被同一个域名连续拒绝、耗时是不是在悄悄变长。
字段落下去之后,要做的是把它挂到监控上,而不是躺在日志库里。规则写三条就够用:单个子账号的小时失败率超过 20% 就告警;同一个出口IP对同一域名连续失败 5 次就自动拉黑该IP;单任务耗时比前七天均值高一倍就提示。第三条尤其有用,它能在目标站点改版、悄悄加验之前给你提个醒。
工具这一层,神龙HTTP 的个人中心里带了可视化用量统计和实时监控,能按子账号看调用趋势、识别异常。实际用下来比较省事的是它会把异常调用标出来,你不用自己写一堆规则去翻日志。另外它的API兼容主流爬虫编程语言,文档和示例代码都齐,接到中台的任务调度里通常半天就能跑通。
四、三个最容易踩的坑
把凭证写在配置文件里,还提交到了代码仓库。这事发生频率高得离谱。凭证走环境变量或者密钥管理服务,别图方便。
只统计总量,不分子账号。总量看着很正常,其实是一个项目在猛跑、另一个项目一直被限流。分维度看,问题才会浮出来。
重试没有上限。没有上限的重试会把一次小抖动放大成一场封禁。加上次数和退避间隔,能少掉一大半半夜的告警电话。
补一句资源本身的选型:数据中台这类场景,一般是短效动态和长效静态搭配着用——高频轮换的公开数据采集走动态池,需要稳定会话的任务走静态池。神龙HTTP 有 3000 万+正规授权代理IP储备、覆盖 300+ 城市级定位,配合前面这套分权与审计的做法,出口这一层基本不需要再天天盯着。他们的技术团队是 7×24 小时支持,遇到提取异常排查起来也快。
常见问题
Q:公司已经有统一出口了,数据中台还要单独接代理IP吗?
看场景。如果只是内部系统之间调接口,统一出口够用。但只要涉及对外的公开数据采集,共享出口几乎必然会被目标站点识别并限制,而且一旦有一路任务被限,其他任务跟着受影响。这时候用代理把出口分散开,反而比维护一个大出口更省心。
Q:子账号是不是分得越细越好?
不是。按"一条业务线一个子账号"来分比较合适,分到每个定时任务一个,管理成本会明显超过收益。判断标准很简单:出问题时你需要能定位到"是哪条业务线",这就够了。
Q:并发数到底按什么定?
先定目标站点的承受节奏,再定自己的并发。可以从 50 并发试跑一小时,看失败率和平均耗时;失败率低于 3%、耗时稳定,再往上加一档。一次加太多,你分不清是目标站点扛不住还是自己代码的问题。
Q:审计日志留多久合适?
热存 30 天、冷存 180 天是个比较实用的做法。30 天内能快速查最近的异常,半年左右足以覆盖一次数据质量复盘。字段上把子账号和出口IP留下就行,不用把响应正文整段存进去,存储成本会失控。