先弄清一件事:你要测的是"通不通",还是"够不够快"
拿到试用账号,很多人的第一反应是:浏览器里配一下代理,随便输个网址,页面出来了,就认定这家的IP能用。
这个动作只能证明一件事——这条线路是通的。它证明不了你要抓的那个站愿不愿意给你内容,也证明不了同样的时间里你能跑多少量。等你把试用额度耗光、正式接进项目,才发现十分钟里有两三分钟请求是失败的,回头再排查,成本就高了。
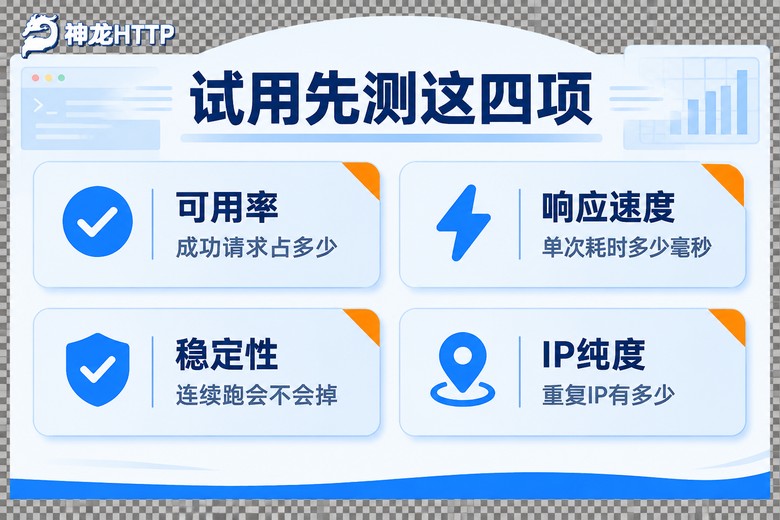
我一般会把试用的验证拆成四个维度看:
可用率:发100次请求,有多少次真的拿到了你要的那段内容。
响应速度:单次请求一来一回要多少毫秒。
稳定性:连着跑二十分钟,成功率是一条平线,还是一条下坡线。
IP纯度:连着发几百次请求,有多少次撞在重复的IP上。
前两个是硬指标,决定你能不能在规定时间里跑完任务;后两个决定你能不能长期跑。四项都测到手,才算摸清了这个池子在你业务里的真实水平。
整轮测试就四步,不用搞复杂
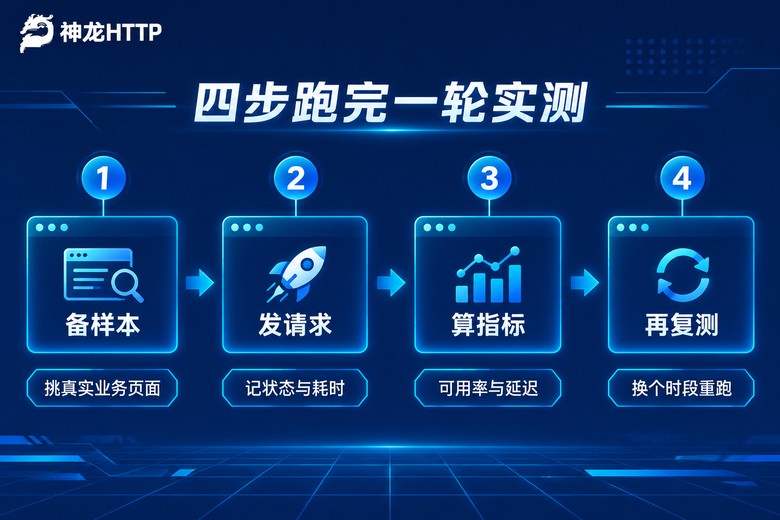
别把这事想得太大。一个下午足够跑完两轮,流程就四步:备样本、发请求、算指标、换时段复测。
四步里最容易被省掉的是最后一步,也恰恰是最不该省的一步。只测一轮,你拿到的只是某个十分钟的成绩单;把样本和方法固定下来换个时段再跑一次,你才看得到波动。
下面一步步来。
把考题准备好:用你真实要抓的请求,别用首页
测试用的请求,最好直接从你线上跑的代码里抠出来。平时抓商品详情页就用详情页,抓搜索列表就用搜索列表。为什么强调这个?因为不同页面在对方服务器那边的"待遇"完全不同:有些页面随便来都能拿到,有些页面要求带着完整的Cookie,还有些页面你请求快一点就先给你一张验证页。
具体准备分三步走:
一、挑典型请求。从现有代码里选5到10个有代表性的请求,URL、请求头、Cookie、参数原样复制下来,别自己改简化。
二、编号固定。给这批请求编上号,后面每一轮测试都用同一批。题目一换,数据就没法对比了。
三、请求节奏贴近真实业务。你业务是一秒钟发3次,测试就一秒钟3次。别为了数据好看把间隔拉到5秒,那测出来的成绩和正式跑是两回事。
还有一个细节,很多人栽在这:判定"成功"不能只看状态码。不少站点被请求得勤了,会正常返回200,但正文里给你一段"访问过于频繁,请稍后重试"。你按200算成功,可用率虚高十几个点都不奇怪。正确的判定要卡三件事——状态码是200、正文里有你要的目标标记、正文里没有拦截提示。
def is_ok(resp):
    """一次请求算不算成功,要同时满足三个条件"""
    if resp.status_code != 200:
        return False
    if "item-price" not in resp.text:      # 目标标记没出现,不算成功
        return False
    if "访问过于频繁" in resp.text:         # 被拦了,正文给了提示
        return False
    return True
跑的时候把每一笔都记下来
接下来就是发请求。这里有个习惯值得养成:每发一次,就往表里记一行流水账——第几次、访问的是哪个地址、成功还是失败、返回了什么、耗时多少毫秒。别嫌麻烦,后面所有的指标都是从这张流水账里算出来的。
import time, requests

PROXY = "http://用户名:密码@通道地址:端口"
URLS  = [u1, u2, u3, u4, u5]      # 上一步固定下来的那批请求

session = requests.Session()
rows = []

for i in range(60):                # 每个地址跑12遍,共600次
    url = URLS[i % len(URLS)]
    t0 = time.perf_counter()
    try:
        r = session.get(url,
                        proxies={"http": PROXY, "https": PROXY},
                        timeout=10)
        ok, code = is_ok(r), r.status_code
    except Exception as e:
        ok, code = False, type(e).__name__
    cost = (time.perf_counter() - t0) * 1000

    rows.append([i + 1, url, ok, code, round(cost, 1)])
    time.sleep(0.3)                # 贴近真实业务节奏

ok_rate = sum(1 for r in rows if r[2]) / len(rows)
costs   = sorted(r[4] for r in rows)
p95     = costs[int(len(costs) * 0.95) - 1]

print(f"可用率 {ok_rate:.2%}  平均 {sum(costs)/len(costs):.0f}ms  P95 {p95:.0f}ms")
两个小地方顺手说一下。计时用 time.perf_counter() 而不是 time.time(),精度更高,也不会被系统时间校准干扰。超时别设太长,10秒足够,设成30秒的话,那些本来就该判失败的请求会把你的平均值拖得面目全非。
样本量也别太抠。跑二十次就下结论,误差大得没意义,建议至少300次起步,有条件跑500到600次。这个量不会吃太多流量,但足够把问题暴露出来。
三个数算出来,好坏就有数了
流水账记完,剩下的就是算。核心就三个数,再加一个辅助的。
| 指标 | 怎么算 | 常见参考线 | 说明 |
|---|---|---|---|
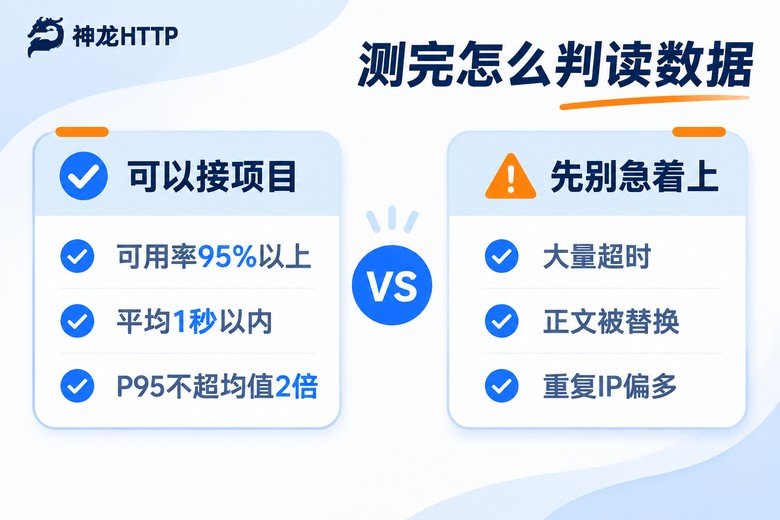
| 可用率 | 成功次数 ÷ 总请求数 | 95% 以上 | 低于90%意味着你要花大量时间在重试上 |
| 平均耗时 | 所有耗时相加 ÷ 请求次数 | 1秒以内 | 容易被少数特别快的请求拉低,别单看它 |
| P95耗时 | 耗时排序后取第95%位置 | 不超过均值的2倍 | 决定那一批慢请求有多拖节奏 |
| 重复IP率 | 重复出现的IP数 ÷ 不重复IP总数 | 5% 以内 | 偏高说明分配到你这块池子被挤得厉害 |
P95 这个数值得单独讲一句,因为它最容易被忽略。把100次请求的耗时从小到大排队,站在第95位的那个数,就是 P95。举例来说:100次里有95次都在400毫秒内完成,剩下5次要3秒,平均下来可能才500毫秒出头,数字看着挺体面。可你实际跑的时候,每20个请求就有1个卡3秒,整个任务的节奏就被拖住了。
所以看响应速度,别只看平均值。平均值告诉你"通常情况下多快",P95 告诉你"最难受的时候有多难受"。这两个差得越远,说明这个池子的线路质量越不齐。
换个时间点再跑一次,数据才算数
同一批请求,隔几个小时再跑一轮。上午十点跑一次,晚上八点跑一次,第二天早高峰再来一次。
为什么要这么折腾?因为代理池是共享资源。白天上班时间大家都在用,晚上可能反而松一些。你要是只在深夜测,数字好看得很;真上线是白天,问题一下就露出来了。
复测还有个更重要的用处——看波动。三轮可用率是 98%、97%、96%,这叫稳;是 98%、82%、95%,这叫抽风。抽风比整体偏低更麻烦,因为你没法预估任务到底要跑多久,排期全乱了。
复测的时候顺手把并发提一点。单线程测出来干干净净,不代表十个并发一起跑也干净。你可以在第二、三轮把请求间隔缩短一半,看看可用率掉多少——掉一点点属于正常,掉一大截说明这条路子撑不住你的业务量。
六个容易把数据测歪的坑
拿首页当考题。首页往往是最轻的页面,缓存也最多,几乎测不出真实难度。要用你业务里最费劲的那个页面。
只认状态码。前面说过,200不等于拿到了内容,正文里可能是一段拦截提示。
一上来就把并发拉满。开测就上200并发,满屏超时,你分不清是IP不行还是自己请求太猛。先单线程跑通,再逐步加压。
样本量太小。二十次请求里错一次就是95%,看起来挺好;实际上再多跑两百次,可能就掉到85%了。
把自己代码的锅算到IP头上。Cookie过期、请求头少了一项、参数拼错,这些在日志里都表现为"请求失败"。测之前先确认不用代理也能正常拿到数据。
用同一批IP死磕同一个页面。有些站会针对单个IP限速,你连着打几十次,测出来的是限速阈值,不是池子的真实水平。多换几个页面、多换几个地区的IP交叉着跑。
试用期短,怎么把每一分钟用在刀刃上
试用额度通常不大,所以更要省着用——别把额度浪费在反复验证"能不能打开网页"上,直接上你那批真实请求。
神龙HTTP 这边有两个地方对测试挺友好。一个是个人中心里的可视化用量统计和实时监控,你脚本在跑的同时,后台就能看到提取了多少IP、消耗了多少流量、哪个时段失败集中,不用自己再额外写一套统计逻辑对着两边的数。另一个是 API 兼容主流爬虫编程语言,文档和示例代码都是现成的,把上面那段脚本里的通道信息换成试用给的,就能直接跑起来,不至于为接入额外耗掉半天。
另外它家短效动态、长效静态、固定IP 几条线都在同一个后台里。你测完短效,要是觉得换IP太频繁影响了需要保持登录态的业务,可以直接切到长效静态再跑一轮同样的脚本做对比,两组数据摆一起,选哪个一目了然。背后是3000万+正规授权代理IP储备、国内三大运营商授权、300+城市级定位,可用率99.9%,高并发提取时的稳定性也值得放进你的测试计划里单独验一验。
测试过程中要是数据和预期对不上,技术团队7×24小时在线,直接把流水账截图发过去问,比自己瞎琢磨快。
常见问题
Q:试用只给几十MB流量,够测吗?
够。你要测的是成功率,不是把整个任务跑完。300到500次请求,如果只取HTML不加载图片和静态资源,一次也就几十KB,加起来二十多MB,三轮完全够。额度紧的话优先测列表页,别去碰图片多的详情页。
Q:可用率多少算合格?
看你要干什么。做公开数据采集,95%以上基本能接受,低于90%你会把大把时间耗在重试上。如果是对时间卡得很紧的定时任务,建议往97%以上看。注意这得是你自己测出来的数,不是宣传页上的数。
Q:为什么我测的时候好好的,正式跑就出问题?
常见三个原因:一是测试时请求间隔放得宽松,正式跑一开并发就撞上对方的限速;二是测试用的Cookie是刚登录的,正式跑的时候过期了;三是测试只覆盖了几个页面,正式跑要碰几十种页面,难度根本不一样。办法很简单——把测试时的并发和间隔调成跟正式一模一样。
Q:测出来某几个地区失败率特别高,是IP的问题吗?
不一定。先去翻失败那几条的返回内容:如果是超时或者连接被重置,可能是那条线路质量一般;如果返回的是一张验证页,大概率是目标站对这类IP段有额外策略。换几个地区的IP跑同一批请求做对比,是池子的问题还是目标站的问题,一眼就能分开。