先搞明白:独享代理“独享”的到底是什么
上个月一个做价格监测的朋友找我排查问题:他的采集任务每天凌晨两点准时挂掉,早上打开一看,数据缺了小半截。代码翻了个底朝天没毛病,最后定位到是那批共享代理——高峰期几十个人挤同一条IP,请求超时、连接中断,重试又把访问频率顶了上去,整批IP接连被目标站点限流。
换成独享代理、补了几行容错逻辑之后,任务连跑两周没再断过。所以先说结论:做大规模采集,独享代理买的不是“快一点”,而是“确定性”——每一分钟采到多少条、失败率压在多少,这些指标只有在一个干净、可控的IP环境里才谈得上稳定。
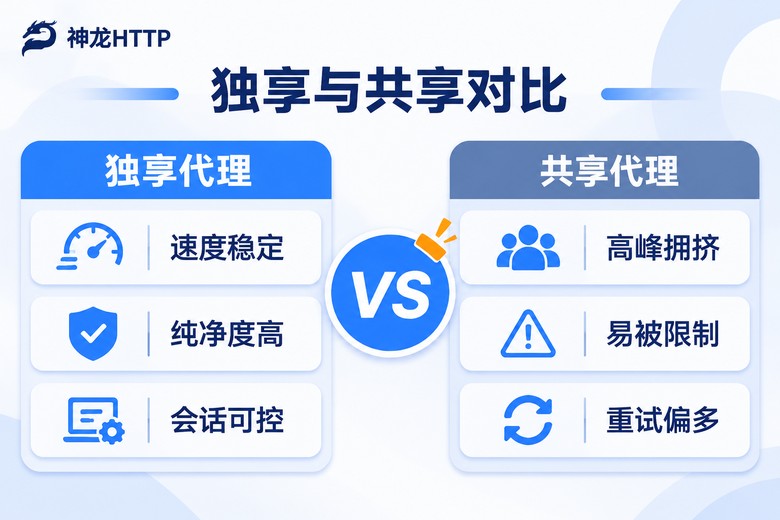
所谓独享,是指这条IP和它的带宽在整个使用期内只属于你一个人:请求节奏自己定、会话保持多久自己说了算、什么时候获取新的IP也由任务自己决定,不用担心别人的行为把这条IP“用脏”。共享代理则相反,一条IP背后可能同时挂着几十个使用者,别人请求太猛你被拖慢,别人触发了限制你跟着遭殃。轻量任务用共享还能凑合,量大、跑得久的任务,这笔账要算清楚。
| 对比维度 | 独享代理 | 共享代理 |
|---|---|---|
| 带宽 | 一人独占,速度可预期 | 多人分摊,高峰期变慢 |
| IP状态 | 使用行为自己掌控,状态干净 | 使用者混杂,容易被“用脏” |
| 长任务 | 会话可保持,流程不断线 | IP频繁变动,流程易中断 |
| 失败率 | 低,重试消耗小 | 偏高,重试又放大请求量 |
| 适合场景 | 大规模、长时间、高要求采集 | 轻量、偶发的抓取需求 |
选独享代理时,我建议优先看IP来源。神龙HTTP的IP来自国内三大运营商的正规授权,储备量在3000万以上,IP纯度做到99.8%、可用率99.9%,300多个城市可以精准定位。来源正规意味着IP底子干净,大规模采集时踩坑的概率会小很多——毕竟任务跑到一半才发现IP本身有问题,返工的代价太高。
实战接入:十来分钟把它跑起来
接入过程比很多人想象的简单,三步:拿到代理地址、写进请求、验证生效。以Python为例,假设你已经在服务商后台生成了独享代理的连接信息(格式以后台给的为准),改动就几行:
import requests

# 代理地址格式以服务商后台提供的为准
proxy_url = "http://用户名:密码@代理主机:端口"
proxies = {"http": proxy_url, "https": proxy_url}

resp = requests.get("https://example.com/data",
                    proxies=proxies, timeout=10)
print(resp.status_code)
print(resp.text[:200])跑通之后别急着放量,先做两个验证。一是确认IP真的生效:让请求访问一个能回显出口IP的测试接口,看返回的是不是代理地址,而不是你本机的网络出口。二是摸清速度底数:拿真实的目标页面试跑几十次,记录平均耗时和失败次数,心里有数之后再上正式任务。
神龙HTTP的API兼容主流爬虫编程语言,后台配了文档和示例代码,Python、Java、Go这些常见语言基本是复制过来改改参数就能跑,接入这一步一般卡不了太久。真遇到问题,他们的技术团队是7×24小时响应的,深夜任务出状况也有人搭手。
稳定性保障的四个工程习惯
接入只是起点。大规模采集想跑得稳,真正拉开差距的是下面这四个习惯。
第一,IP先预检再上岗。拿到一批独享IP后,先用轻量请求逐个探测:能否连通、响应多少毫秒、返回内容是否正常。把不合格的筛掉再开任务,启动阶段的失败率能降一大截。这一步成本极低,收益却很直接。
第二,给请求定节奏。很多任务挂掉不是IP不行,而是请求太猛。给每个目标站点设频率上限,比如每秒不超过几个请求,请求之间加随机间隔,模拟正常人浏览网页的节奏。宁可整体慢一点,也别让目标站点把你当成异常流量处理。
第三,失败后获取新的IP续跑,而不是原地硬重试。重试逻辑要和代理配合:请求失败时取一个新的独享IP接着试,间隔按指数退避逐次拉长。这样单点故障不会拖垮整个任务。
import time
import requests

def fetch_with_retry(url, max_retry=3):
    for attempt in range(1, max_retry + 1):
        proxy = get_new_proxy()  # 每次重试取一个新的独享IP
        proxies = {"http": proxy, "https": proxy}
        try:
            resp = requests.get(url, proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp.text
        except requests.RequestException:
            pass
        time.sleep(2 ** attempt)  # 间隔2秒、4秒、8秒递增
return None第四,长任务保持会话。需要维持登录态或分步操作的任务,让同一段流程走同一条IP:把会话参数固定住,从第一步到最后一步都用同一个出口,中间不会因为出口变动导致状态丢失。顺带一提,用会话对象复用连接,还能省下反复握手的时间:
session = requests.Session()
session.proxies.update(proxies)
# 后续请求直接 session.get(...),连接可复用,延迟更低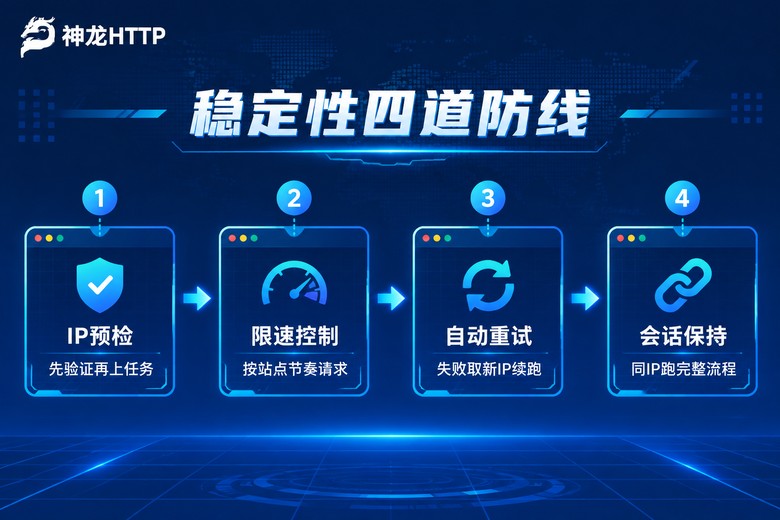
跑起来之后:用监控把稳定性守住
任务上线不等于万事大吉,我每天固定看两样东西。
一是成功率曲线。把每小时的成功数和失败数记下来画成曲线,成功率突然下坠,多半是目标站点改了页面结构,或者某段IP出了状况,能第一时间发现。二是用量分布。神龙HTTP的个人中心里有可视化的用量统计和实时监控,流量消耗、各时段的用量波动一眼可见,还能帮助识别异常。有次我发现凌晨用量比平时高出一倍,追下去是重试条件写错、失败后陷入了循环——没有这块监控,流量就这么无声无息烧掉了。
再补一道保险:给任务设告警,连续几分钟成功率低于阈值就发通知。半夜任务停了不可怕,可怕的是停了一整晚没人知道,第二天对着一片空洞的数据表发呆。
把这几层做完——干净的独享IP、预检、限速、自动重试、会话保持、监控告警——你会发现所谓“稳定性”并不是什么玄学,就是把每个可能掉链子的环节都提前补上。大规模采集拼到最后,拼的是这些细节的完成度。

常见问题
Q: 独享代理比共享贵,真的值得吗?
算一笔账就清楚了:共享代理单价低,但失败率高,重试会成倍放大请求量和时间成本,任务中途断掉还得人工排查。大规模采集里,时间和返工成本往往比代理费用高得多,独享带来的确定性通常更划算。轻量、偶尔跑一次的小任务,用共享也够。
Q: 用了独享IP,还会被目标站点限制吗?
有可能。独享解决的是IP质量和可控性问题,不代表可以无限猛发请求,限制大多由访问节奏触发,所以预检、限速、随机间隔这些习惯一个都不能少。真被限制了,获取一个新的独享IP继续任务即可,独享环境下新IP的状态是干净的。
Q: 大规模任务大概需要多少个独享IP?
没有统一答案,取决于目标站点的限制策略、采集频率和单IP的承压能力。实用的做法是先小规模试跑:用10个IP跑一小时,记录每个IP的请求上限和失败拐点,再按目标总量线性推算,并留出20%到30%的余量。
Q: 独享代理支持哪些协议?程序接入麻烦吗?
神龙HTTP支持HTTP、HTTPS、SOCKS5三种协议,覆盖常见的采集场景。接入方面,后台提供文档和各主流语言的示例代码,把示例里的地址和认证信息换成自己的就能跑,一般十几分钟能完成从生成代理到第一次成功请求的全流程。