先说个真事:请求卡在第一步,多半是出口太单一
前阵子帮朋友看一个采集脚本,跑得好好的,第二天开始整页整页返回 403。他以为是选择器写错了,改了半天 XPath,其实页面根本没渲染出来——对方一看同一个出口访问太勤,直接把门关了。
这类问题的解法不复杂:让请求从不同的出口出去。在 Scrapy 里这件事有三层做法,从粗到细分别是——给单个请求挂代理、写成下载中间件自动分配、对接一个能持续供货的代理池。下面按这个顺序走一遍,代码都能直接抄。
第一层:一个 meta 就能挂上代理
Scrapy 自带 HttpProxyMiddleware,你不需要自己拼请求头,只要往 request.meta 里塞一个 proxy 键,后面的事它替你办了。
import scrapy


class PriceSpider(scrapy.Spider):
    name = "price"
    start_urls = ["TARGET_URL"]  # 换成你要抓的页面

    def start_requests(self):
        for url in self.start_urls:
            yield scrapy.Request(
                url,
                meta={"proxy": "http://123.45.67.89:8080"},
                callback=self.parse,
            )

    def parse(self, response):
        self.logger.info("状态码 %s", response.status)
        # 正常写你的解析逻辑
如果代理需要账号密码,直接写进 URL 里就行,Scrapy 会自动生成认证头:
# 格式:http://用户名:密码@主机:端口
proxy = "http://myuser:mypass@123.45.67.89:8080"
request.meta["proxy"] = proxy
要提醒一句:密码里如果带 @、:、/ 这些符号,先用 urllib.parse.quote 转义一下,不然 URL 会被切得七零八落,报错信息还看不懂。
这种写法适合调试和小规模验证。真跑起来几百个请求,你不可能手写几百个 meta,所以往下走一步。

第二层:写成下载中间件,每个请求自动带代理
中间件的作用就一句话——在请求出门之前,替你把该填的字段填好。新建一个 middlewares.py(Scrapy 建项目时已经有了),在里面加这个类:
import random


class RandomProxyMiddleware:

    def __init__(self, proxy_list):
        self.proxy_list = proxy_list

    @classmethod
    def from_crawler(cls, crawler):
        # 从 settings.py 里的 PROXY_LIST 读取
        return cls(crawler.settings.getlist("PROXY_LIST"))

    def process_request(self, request, spider):
        if request.meta.get("proxy"):
            return None  # 这个请求已经指定了,别覆盖
        request.meta["proxy"] = random.choice(self.proxy_list)
        return None
然后去 settings.py 里开户:
PROXY_LIST = [
    "http://用户名:密码@主机:端口",
    "http://用户名:密码@主机:端口",
]

DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.RandomProxyMiddleware": 543,
}
543 这个数字别随便改。Scrapy 内置的 HttpProxyMiddleware 默认排在 750,它是在 750 这一步去读 meta["proxy"] 的。你自定义的中间件必须排在它前面(数字更小)执行,meta 才来得及填进去。我第一次配的时候写了 900,跑了半天发现请求全是直连,日志里干干净净,一点提示都没有,排查了快一个小时。
第三层:对接代理池,用完一个换一个
到这一步,思路要从"准备一个列表"变成"接一个水龙头"。短效动态 IP 的存活时间通常只有几分钟到几十分钟,你提前拉一堆放在列表里,等轮到时早就过期了。
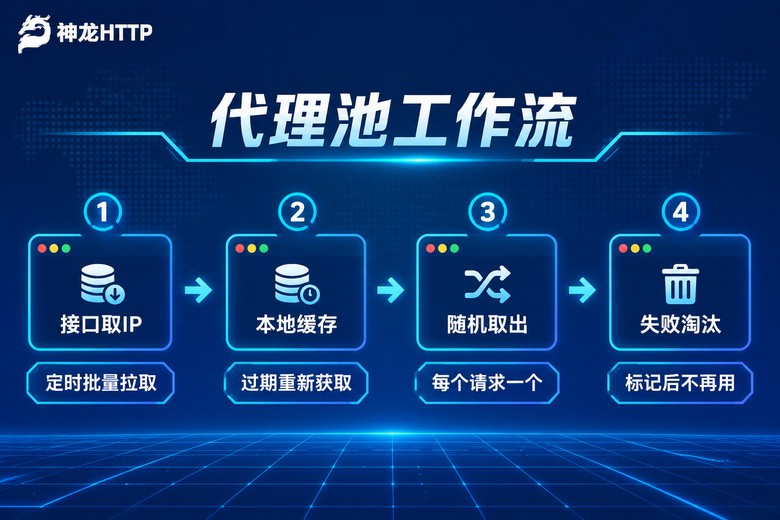
合理的做法是自己维护一个很小的本地队列:按需批量拉取、缓存一个有效期、用完再取、坏的直接踢掉。这段代码不长,但很关键:
# proxy_pool.py
import time
import requests


class ProxyPoolClient:

    def __init__(self, api_url, ttl=60):
        self.api_url = api_url
        self.ttl = ttl
        self._queue = []
        self._fetched_at = 0
        self._bad = set()

    def _refill(self):
        resp = requests.get(self.api_url, timeout=8)
        resp.raise_for_status()
        # 接口通常一行一个 ip:port
        lines = [x.strip() for x in resp.text.splitlines() if x.strip()]
        self._queue = [f"http://{x}" for x in lines]
        self._fetched_at = time.time()

    def get(self):
        expired = (time.time() - self._fetched_at) > self.ttl
        if not self._queue or expired:
            self._refill()
        return self._queue.pop()

    def mark_bad(self, proxy):
        if proxy:
            self._bad.add(proxy)
然后把中间件改成从池子里取:
class PoolProxyMiddleware:

    def __init__(self, pool):
        self.pool = pool

    @classmethod
    def from_crawler(cls, crawler):
        pool = ProxyPoolClient(
            api_url=crawler.settings.get("PROXY_API"),
            ttl=crawler.settings.getint("PROXY_TTL", 60),
        )
        return cls(pool)

    def process_request(self, request, spider):
        if not request.meta.get("proxy"):
            request.meta["proxy"] = self.pool.get()
        return None

    def process_response(self, request, response, spider):
        if response.status in (403, 407, 429):
            self.pool.mark_bad(request.meta.get("proxy"))
        return response
settings 里对应加两行就行:
PROXY_API = "你的提取接口"
PROXY_TTL = 60          # 缓存 60 秒,过期重新取
DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.PoolProxyMiddleware": 543,
}
ttl 设多少合适?我的经验是比 IP 的实际存活时间短一半。比如拿到的 IP 大概能用 5 分钟,ttl 就写 120 秒左右,宁可多取一次,也别拿到一堆已经死掉的地址去撞墙。
出错了别硬扛:重试和换 IP 要配合好
只换 IP 不换策略,照样会被拦。Scrapy 内置的重试机制默认只对少数几个状态码生效,你得把常见的拦截码加进去:
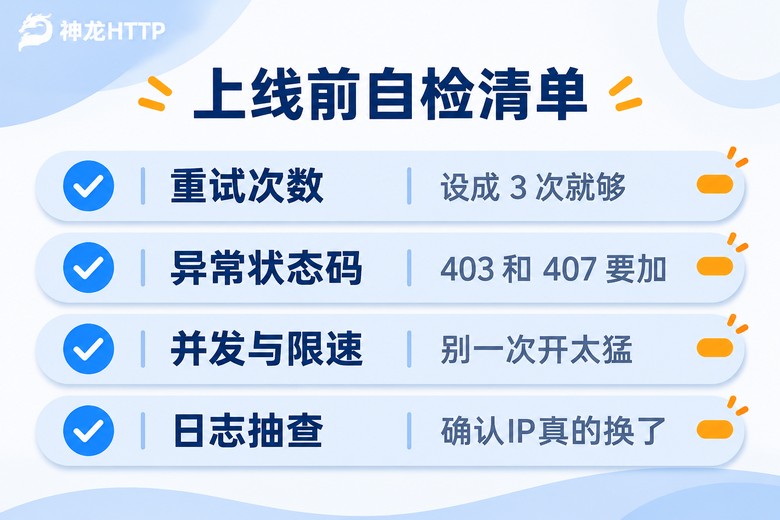
RETRY_ENABLED = True
RETRY_TIMES = 3
RETRY_HTTP_CODES = [403, 407, 408, 429, 500, 502, 503, 504]
光加状态码还不够,有些情况压根没返回响应,直接抛异常(连接超时、隧道建立失败)。这时候可以在中间件里补一个 process_exception,把坏 IP 拉黑,然后拿新的重发一次:
def process_exception(self, request, exception, spider):
    old = request.meta.get("proxy")
    self.pool.mark_bad(old)

    tried = request.meta.get("retry_times", 0)
    if tried >= 3:
        return None  # 已经试够次数,交给 Scrapy 记录失败

    new_request = request.copy()
    new_request.meta["proxy"] = self.pool.get()
    new_request.meta["retry_times"] = tried + 1
    new_request.dont_filter = True
    return new_request
另外两个参数顺手调一下,能少踩很多坑:CONCURRENT_REQUESTS 别一上来就开到很大,先 8 或 16 试水;DOWNLOAD_DELAY 给个 0.5 秒,再打开 AUTOTHROTTLE 让 Scrapy 自己根据响应速度收放。这些东西比换多少 IP 都管用,因为对方拦的是"行为模式",不只是地址。
配置完一定要验证一次。最简单的办法是在 parse 里打一行日志,把 response.meta.get("proxy") 打出来,再找一个会回显请求信息的测试接口看一眼出口。如果打出来的还是你自己的机房地址,那基本可以确定中间件序号写错了。
代理服务怎么挑:看三个硬指标
中间件写得再漂亮,底下的 IP 池不给力也是白搭。挑服务的时候我主要看三点:能提取多少、活着的有多少、挂了多久能被换掉。
神龙HTTP 在这几项上比较实在:3000万+ 正规授权代理IP储备,可用率 99.9%,IP 纯度 99.8%,覆盖 300+ 城市级精准定位。它家有短效动态IP、长效静态IP、固定IP代理几条产品线,接口返回的就是一行一个 ip:port,上面那段 _refill() 几乎不用改就能对接。API 兼容主流爬虫编程语言,文档和示例代码都有,技术团队 7×24 小时在。另外个人中心里的可视化用量统计挺省心,能看提取量趋势,也能及时发现某个时段消耗异常——调 ttl 和并发的时候,这个页面比日志直观多了。
| 代理类型 | 适合的场景 | 在 Scrapy 里怎么接 |
|---|---|---|
| 短效动态IP | 请求量大、每页之间没有关联的公开数据采集 | 每次 get() 换一个,配合 ttl 缓存 |
| 长效静态IP | 需要连续会话、同一来源要保持一致的任务 | 在中间件里固定,不随机轮换 |
| 固定IP代理 | 长期稳定对接、需要白名单授权的项目 | 直接写进 settings 常驻 |
选型的判断标准其实很简单:你的任务是不是"一页一个身份"。如果是,短效动态最划算;如果整个流程要求用同一个出口走完,那硬省这点钱没意义,直接上长效静态。
常见问题
Q:明明挂了代理,为什么还是返回 403?
先按日志确认代理真的生效了——打印 response.meta.get("proxy") 看有没有值。生效了还 403,一般是这个出口的 IP 已经被标记过,或者请求频率太密。把 DOWNLOAD_DELAY 调大一点,同时让每次请求都换新 IP,通常能缓解。另外检查一下请求头里的 User-Agent 有没有跟着换,只有 IP 换了、指纹没换,也很容易露馅。
Q:代理需要账号密码,中间件里怎么拼才不出错?
直接把认证信息写在 URL 里:http://用户名:密码@主机:端口,Scrapy 会自动生成认证头,不用你手动加。唯一要注意的是密码含特殊字符时先做 URL 编码。如果接口返回的串本身带认证信息,那基本可以原样拼上 http:// 前缀使用。
Q:某些请求想直连、不走代理,怎么处理?
在中间件里先判断 request.meta.get("proxy"),有值就直接 return None 交给后面的流程,别再覆盖。需要直连的请求提前把这个键设成空字符串或者干脆不设;需要走代理的再显式指定。这样一套中间件能同时管住两类请求,不用拆成两个爬虫。
Q:IP 消耗得特别快,有办法省一点吗?
三个地方可以下手。一是把 ttl 设得稍微贴近 IP 实际存活时间,别让缓存过早失效;二是只对真正被拦截的请求换 IP,正常返回的复用一个出口;三是把并发压下来,很多消耗其实来自重复重试。神龙HTTP 个人中心的用量统计能看清是哪一类请求在吃配额,对着数据调比凭感觉靠谱。