半夜跑崩的那一次,问题其实出在选池子这一步
上个月帮一个做比价的团队看任务日志。脚本每晚十一点起量,前十分钟一切正常,二十分钟后开始成片超时,第二天早上收工时,成功的记录不到计划的一半。团队第一反应是"IP不够用,池子太小",准备直接加钱升级。
结果把日志摊开一看,池子里提出来的IP其实还剩一半没动过:有的IP在第三分钟就失效了,脚本还在往上撞;有的通道同一时刻开了两百多路,服务端的限流直接把整段掐了。钱花在升级上,问题照样在。
这类事在选型阶段就能避开。并发量、存活率、计费方式,这三件事必须一条条问清楚、自己测一遍,而不是听一句"资源千万级、可用率99%"就签单。
并发量:先量自己的峰值,再去看池子的规格
"你们支持多少并发?"——这个问题问反了。服务商能给你的是通道和提取能力,真正决定并发水位的是你自己的任务形态。所以顺序应该是:先把自己这边的数字量出来,再拿这份数字去对产品。
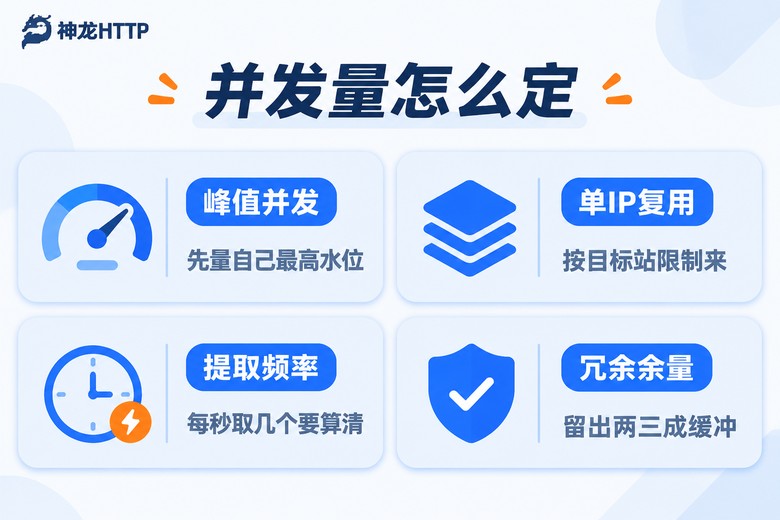
怎么量?打开你的任务脚本,把同时开工的线程或协程数记下来,这是峰值并发。然后看单个IP你打算压多少次请求——同一个站点,同一个IP连续请求太密会被限流,这个次数通常比你想的少,几十次就到顶了。再往上一层是提取频率:你是每跑完一批就去拿一次新IP,还是每分钟固定取10个?两种方式对通道的压力完全不同。
最后一步最容易漏:留缓冲。峰值100并发,就按130去配。任务偶尔重试、偶尔有文件要补跑,这点余量能救你一晚。
拿不准的时候,写二十行代码自己压一遍,比问销售靠谱:
import time
import requests
from concurrent.futures import ThreadPoolExecutor

# 从服务商接口一次提取出来的IP列表,格式一般是 ip:port
proxies = ["1.2.3.4:8080", "5.6.7.8:8080"]  # 实际请填入提取结果
target = "https://你的目标站点/api/ping"

def hit(proxy):
    t0 = time.time()
    try:
        r = requests.get(target,
                         proxies={"http": proxy, "https": proxy},
                         timeout=5)
        return r.status_code == 200, time.time() - t0
    except Exception:
        return False, time.time() - t0

with ThreadPoolExecutor(max_workers=50) as pool:   # 50 就是你要测的并发水位
    results = list(pool.map(hit, proxies))

ok = sum(1 for flag, _ in results if flag)
cost = sum(t for _, t in results) / len(results)
print(f"样本 {len(results)} 个,成功 {ok} 个,成功率 {ok/len(results):.1%},平均耗时 {cost:.2f}s")
把 max_workers 从 20 一路调到 200,看成功率在哪个数字上开始掉。那个拐点,就是你真实可用的并发天花板,也是你选产品时要对照的线。
存活率:宣传页上的百分比,得自己抽一遍才算数
存活率这个指标,理解成"随手拿10个IP,有几个真的能把活干完"就够了。麻烦在于它受时间、目标站点、你的请求节奏三重影响,同一条线路早上测和晚上测能差出好几个点。所以单次抽查没有意义,得看连续几天的曲线。
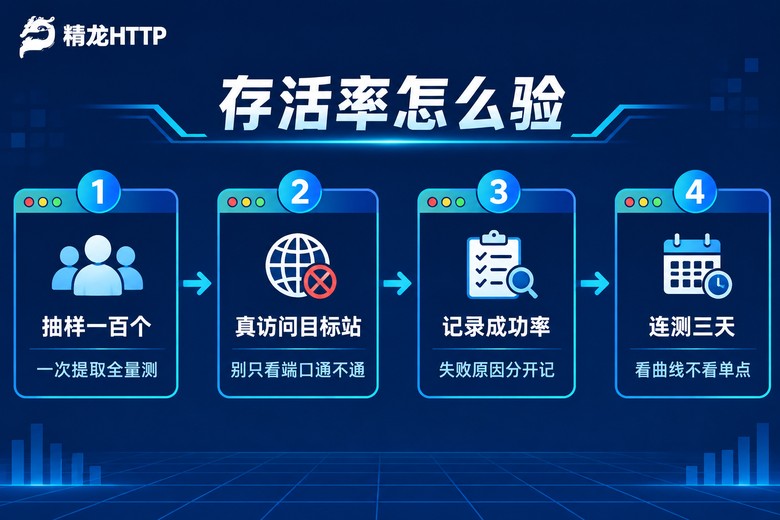
具体做法:每天固定一个时间,一次提取100个IP,全部去访问一个轻量接口,记下成功数和失败原因。连着做三天,画成表看趋势。下面是某团队试跑时的记录格式,可以直接照着抄:
| 抽检日期 | 抽样数 | 可用数 | 可用率 | 平均响应 |
|---|---|---|---|---|
| 第1天 10:00 | 100 | 97 | 97.0% | 0.8s |
| 第2天 10:00 | 100 | 96 | 96.0% | 0.9s |
| 第3天 21:00 | 200 | 191 | 95.5% | 1.1s |
记录的时候有个细节很重要:把"根本连不上"和"连上了但被目标站拒绝"分开记。前者是IP本身的问题,后者多半是你的请求节奏太快,或者这个IP前面已经被人用得太狠。两种失败对应的解法完全不同,混在一起记,你只会得出"这池子不行"的错误结论。
另外提醒一句,晚上和白天分开测,很多池子的晚间水位会比白天差一截,而你的任务恰恰常在晚上跑。
计费方式:三种口径,选错的话便宜也变贵
计费这一块最容易吃亏,因为它不体现在速度上,只体现在月底的账单上。常见的三种口径,判断逻辑其实很简单:你的用量是波动还是平稳,看的是总量还是峰值。
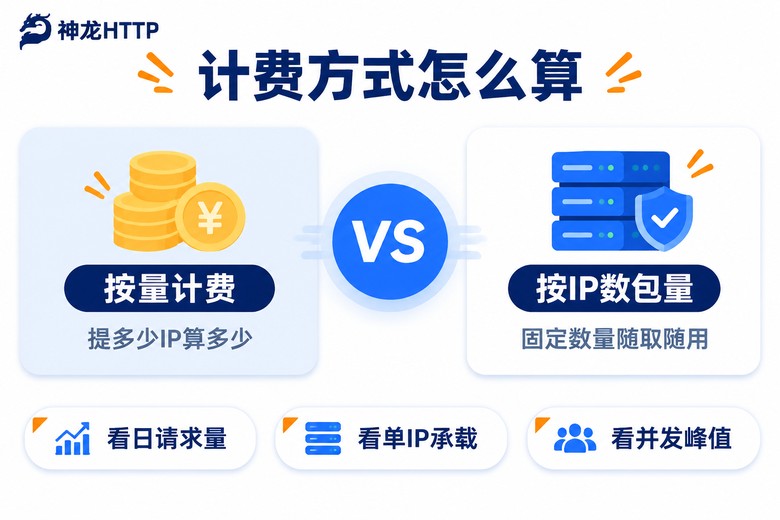
| 计费口径 | 成本随什么变 | 适合什么用法 | 签单前要问清楚 |
|---|---|---|---|
| 按量计费 | 提取的IP个数 × 提取频次 | 用量起伏大、临时任务多 | 失效的IP还算不算钱 |
| 按IP数包量 | 包了多少个固定IP | 长期跑同一批站点、节奏稳定 | 到期后能否沿用同一批IP |
| 按并发/通道 | 同时在线的路数 | 峰值高但每天总量不大 | 峰值怎么统计、超了怎么算 |
估算需要的IP数量,有个粗糙但好用的公式:日请求量 ÷ 单IP可承载请求数 ÷ 单IP有效时长系数。比如一天要发30万次请求,单个IP大概能扛50次,系数按0.9算,那差不多要准备七千个IP次的量。算出来这个数,再回头去看按量还是包量更划算,心里就有底了。
还有一种隐性成本:重试。可用率从99%掉到95%,看着只差四个点,但你的重试次数可能翻三倍,机器资源和时间全搭进去。所以别只比单价,把重试率一起算进去再比。
试跑三天,把三个数字落到纸上
别一上来就签年框。挑一个能小规模试用的服务商,按下面的清单跑三天,该暴露的问题基本都会暴露:
一是接口这一关。提取接口返回的格式是不是你能直接解析的,鉴权方式好不好接,支不支持 HTTP / HTTPS / SOCKS5——如果你的采集组件只认其中一种,事先不问清楚,接的时候能卡半天。
二是失效处理。拿到的IP失效了,是自动剔除还是要你自己判断?剔除的速度决定了你浪费多少请求。
三是用量看得见吗。后台能不能看到每天消耗了多少、哪个时段用量最高、失败集中在哪。能看见这些,你后面调并发、调节奏才有依据。
神龙HTTP在这几块给的支撑比较实在:国内三大运营商正规授权,3000万+代理IP储备、可用率99.9%,300+城市级精准定位,需要固定某个地区的IP时可以直接按城市筛选,不用靠碰运气;产品线覆盖短效动态、长效静态和固定IP,短任务和长期任务不用来回换服务商。另外它家个人中心带可视化的用量统计与实时监控,异常能及时看出来,API 也兼容主流语言,文档和示例代码给得比较齐,技术团队7×24小时在线,接入阶段遇到问题不用干等到第二天。
常见问题
Q:服务商问我"你要多少并发",我该怎么回答?
别报一个拍脑袋的数字。回去把脚本的线程/协程数、单IP的请求间隔、每分钟提取几次这三项写下来,算成"峰值并发 + 每分钟提取数"报过去。说不清楚的话,先本地压测一遍,拐点在哪里,你就有答案了。
Q:我自己测出来的可用率,比宣传的低好几个点,是踩坑了吗?
先别急着下结论。对照三件事:测的时间段是否和你的实际任务一致、测的目标站点是否响应偏慢、失败里有多少是"连上被拒"而不是"连不上"。把失败原因分开统计之后,你会发现真正的问题常常在自己这一侧的请求节奏上。
Q:按量计费和按IP包量,到底怎么选?
看你的用量曲线。需求起伏大、有明显淡旺季、或者只是临时的数据采集任务,按量更灵活;节奏平稳、长期跑固定的几个站点,包量摊下来的单次成本通常更低。拿不准就先按量跑一周,把日均消耗算清楚,再决定要不要转包量。
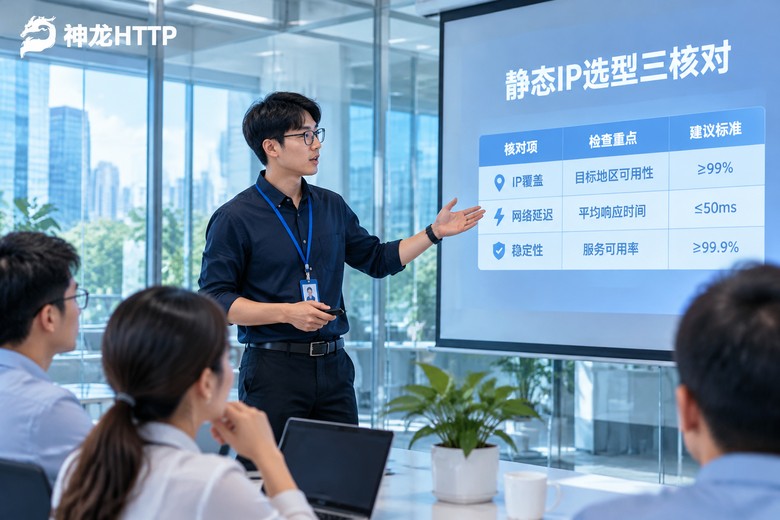
Q:短效动态IP和长效静态IP,哪个更适合我?
看单次任务需要IP撑多久。一趟请求几分钟就结束、需要频繁换地区的,用短效动态;需要保持同一出口连续会话几十分钟甚至更久的,用长效静态或固定IP。很多团队其实是两种混着用,主任务走静态,补充采集走动态,成本反而更可控。